La documentación de Anthropic en español trae una regla para saber si una instrucción está lista: «Muestra tu prompt a un colega con un contexto mínimo sobre la tarea y pídele que lo siga». La frase que sigue lo completa: si el colega se confundiera, Claude también se confundiría.
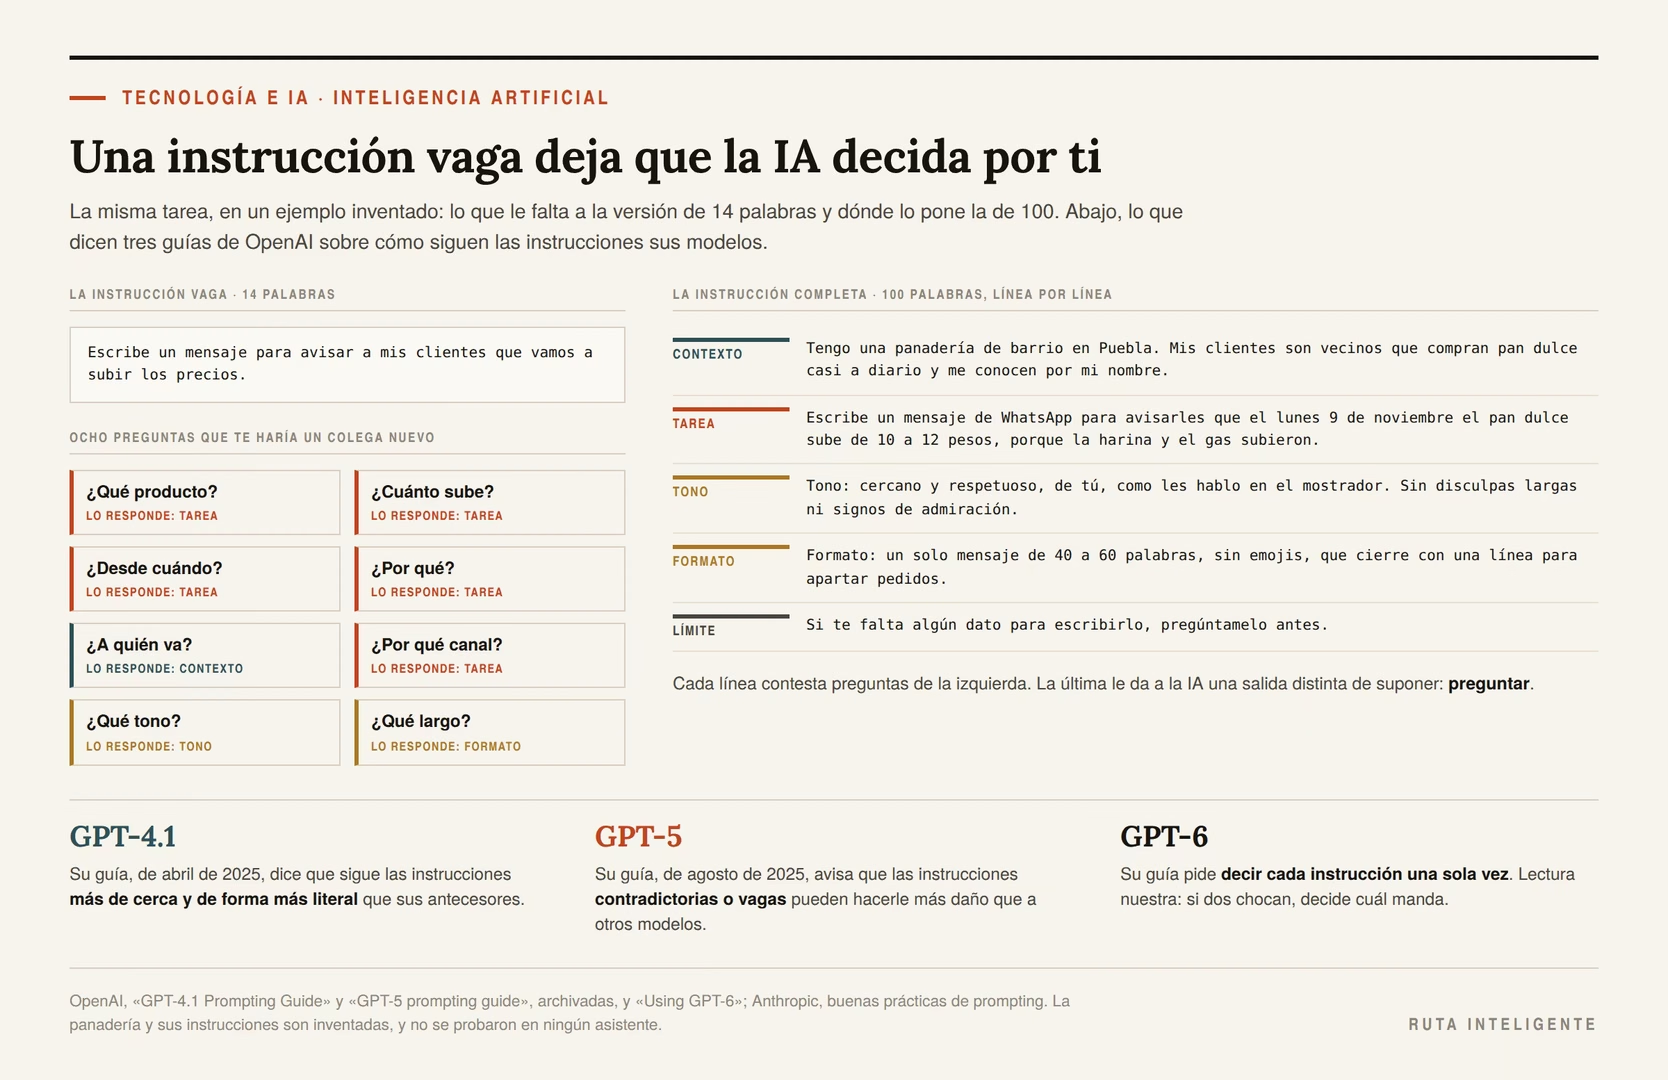
Haz la prueba con esta instrucción, que es inventada: Escribe un mensaje para avisar a mis clientes que vamos a subir los precios.
Un colega que no conoce tu negocio te haría al menos ocho preguntas. Qué producto sube y cuánto. Desde cuándo y por qué. A quién va el mensaje, por qué canal, con qué tono y de qué largo. Si la instrucción no lo dice, lo decide la IA.
De eso trata esta guía. Una instrucción sirve cuando trae lo que solo tú sabes y pide lo que de verdad necesitas.
En el trabajo, buena parte de lo que se le pide a una IA es escribir. OpenAI analizó cómo se usa ChatGPT, y la escritura encabeza los usos de trabajo. Lo dice así: «Writing is the most common use case at work, accounting for 40% of work-related messages on average in June 2025». Traducción nuestra: escribir es el uso más común en el trabajo, con 40 % de los mensajes relacionados con el trabajo, en promedio, en junio de 2025.
Y la mayor parte de los mensajes de escritura, del trabajo o no, no pide textos nuevos: «About two-thirds of all Writing messages ask ChatGPT to modify user text». Traducción nuestra: cerca de dos terceras partes de todos los mensajes de escritura le piden a ChatGPT modificar un texto del usuario. Corregir, resumir, traducir o cambiar el tono de algo que ya escribiste también es dar instrucciones.
En México, el Banco de México encuestó en junio de 2026 a empresas de más de 100 trabajadores sobre su uso de herramientas de inteligencia artificial. Su cifra para todo el país: «El 48.5% de las empresas de más de 100 trabajadores en el nivel nacional reportó utilizar al menos una de estas tecnologías». De los negocios más chicos no encontré una cifra oficial.
Las empresas que hacen estas herramientas publican cómo pedirles las cosas. Revisé seis guías de cuatro empresas: OpenAI, Anthropic, Google y Microsoft. En lo básico coinciden: decir qué quieres, dar el contexto y pedir un formato. Difieren en detalles, como cuántos ejemplos dar y dónde poner la pregunta.
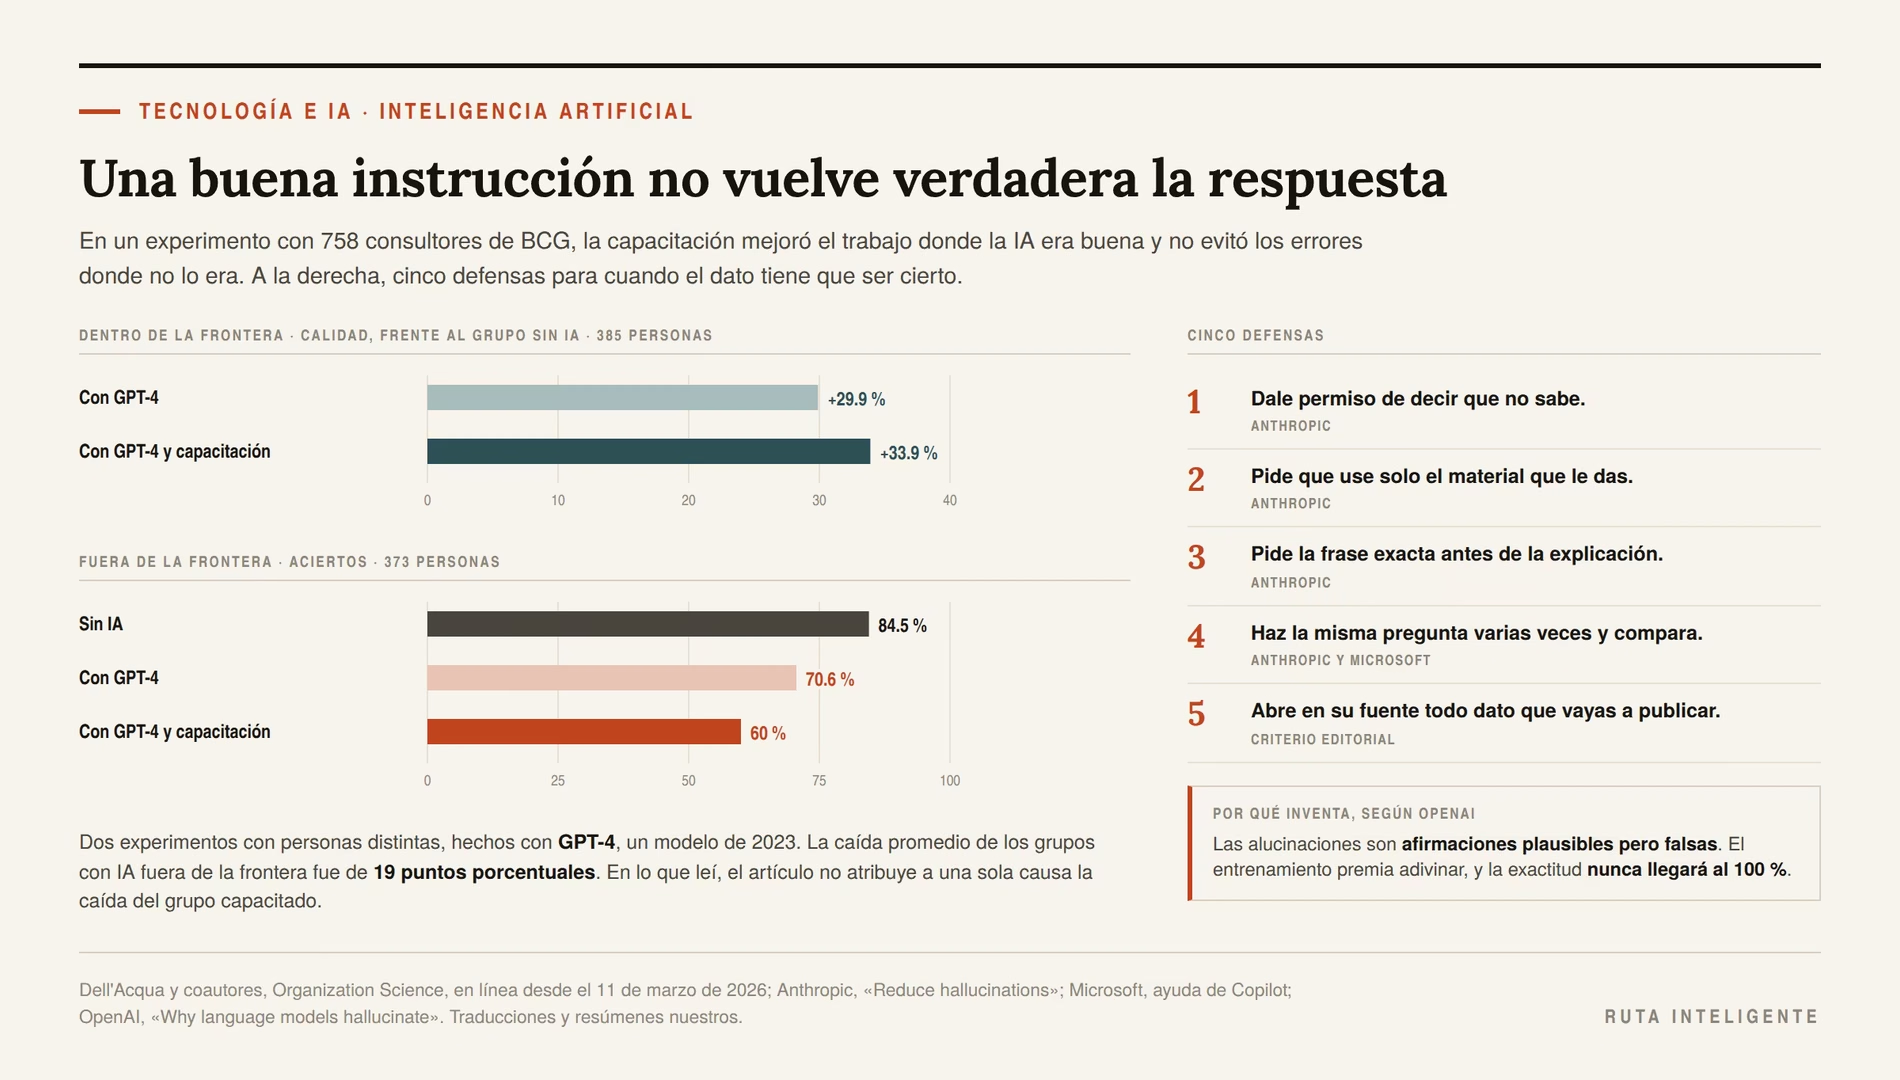
También hay un experimento que pone la técnica en su lugar. Participaron 758 consultores de Boston Consulting Group, en dos experimentos con personas distintas. En cada uno hubo tres grupos: sin IA, con IA y con IA más una capacitación sobre cómo usarla. En las tareas que la IA hacía bien, la calidad del grupo capacitado fue 33.9 % mayor que la del grupo sin IA, y la del que solo tuvo la herramienta, 29.9 % mayor. Fuera de lo que la IA hacía bien, el grupo capacitado acertó 60 % de las veces; el que solo tuvo la herramienta, 70.6 %, y el que trabajó sin IA, 84.5 %.
Lectura nuestra: escribir mejores instrucciones mejora lo que la IA ya hace bien. No te protege de lo que hace mal.
Esto vas a encontrar abajo.
- Las guías de las cuatro empresas piden lo mismo en tres puntos: qué quieres, con qué contexto y en qué formato. En los ejemplos y en el orden no coinciden, y aquí verás cuándo seguir a cuál.
- Lectura nuestra: lo básico de las guías cabe en cinco piezas: la tarea, el contexto, el formato, los ejemplos y los límites. Hay cinco instrucciones de negocios mexicanos, antes y después, todas inventadas.
- Con documentos largos, la pregunta va al final. Anthropic dice que eso puede mejorar la calidad de la respuesta hasta en un 30 % en pruebas, y Google pide lo mismo.
- Con los modelos que razonan, OpenAI pide instrucciones simples y directas, y desaconseja pedirles que piensen paso a paso.
- Ofrecer propina o amenazar no tuvo, en general, efecto significativo en dos bancos de pruebas, según un informe de 2025 del laboratorio de IA generativa de la Wharton School. Y decirle a la IA que es experta no mejoró sus respuestas en 2,410 preguntas sobre hechos.
- Con Claude, no hace falta escribirle en inglés. En la tabla de Anthropic, Claude Sonnet 4.5, ya retirado, rindió en español 98.2 % de lo que rindió en inglés, y Claude Haiku 4.5, 96.4 %.
- Google pide no escribir en Gemini nada confidencial que no quieras que vea un revisor. Antes de pegar datos de tus clientes, lee «Lo que no conviene pegar».
Tres avisos antes de empezar. Esta guía nombra a ChatGPT, Claude, Gemini y Copilot porque sus empresas publican las guías que cita, no porque recomiende alguno, y no tiene enlaces de afiliado. Las instrucciones de ejemplo son inventadas y no las probé en ningún asistente: muestran las reglas, no prometen un resultado. Y la parte de datos personales es información general, no asesoría legal.
Las citas de documentos en inglés van en su idioma original, seguidas de una traducción nuestra. Las de la guía de buenas prácticas de Anthropic van en español, como las publica su documentación en español; sus ejemplos y sus otras páginas, en inglés. Cada fuente está enlazada en «Fuentes y metodología».
La versión de un minuto
Si solo vas a leer una sección, que sea esta. Son siete reglas que salen de las guías oficiales y de los estudios que se citan abajo.
- Di qué quieres con un verbo y un entregable. Escribe un mensaje de WhatsApp de 40 a 60 palabras dice lo que ayúdame con un mensaje deja al azar.
- Da el contexto que la IA no tiene: quién eres, para quién es y para qué. Si una regla importa, explica por qué.
- Pide un formato que se pueda medir: cuántas palabras u oraciones, en qué forma y con qué tono. Di qué hacer, no solo qué evitar.
- Si tienes ejemplos de lo que quieres, pégalos. Anthropic recomienda de 3 a 5.
- Pon límites: con qué material trabajar y qué hacer si falta un dato.
- Con un documento largo, el documento arriba y la pregunta abajo.
- Revisa en su fuente cualquier dato que vayas a publicar o a usar para decidir.
Lo demás tiene menos respaldo para mejorar la exactitud. El rol sirve para el tono; la cortesía, las propinas y las amenazas se revisan en «Siete mitos sobre las instrucciones».
Y una regla de sentido común antes de todas. Si escribir la instrucción te toma más que hacer la tarea, haz la tarea.
Por qué una instrucción vaga da una respuesta genérica
Lectura nuestra: un asistente trabaja con lo que le escribes, con lo que aprendió al entrenarse, con lo que le diste antes y con lo que encuentre si busca en internet. Lo que es de tu negocio y no está publicado, no lo tiene.
La IA no sabe lo que tú sabes
Anthropic lo explica con una comparación: «Piensa en Claude como un empleado brillante pero nuevo que carece de contexto sobre tus normas y flujos de trabajo».
La guía de Google para su API dice algo parecido. Pide incluir en la instrucción lo que el modelo necesita para resolver la tarea, «instead of assuming that the model has all of the required information». Traducción nuestra: en lugar de suponer que el modelo tiene toda la información necesaria.
Piensa en lo que un empleado nuevo no sabe el primer día. Cuánto cobras. Quiénes son tus clientes. Cómo les hablas. Qué pasó la semana pasada con el proveedor. Qué intentaste y no funcionó.
Deducción nuestra: como es de tu negocio, es difícil que venga en el entrenamiento de un modelo. Qué es esta tecnología y dónde rinde en una empresa pequeña está en qué es la inteligencia artificial y cómo usarla en negocios.
Lo que no dices, lo rellena
Deducción nuestra: si la instrucción no fija un dato, la respuesta lo fija igual. Un aviso de aumento de precio tiene un largo, un tono y un cierre, los pidas o no. Si no los pides, los elige el modelo.
OpenAI pone un ejemplo en su guía de buenas prácticas para la API. Una instrucción imprecisa: «The description for this product should be fairly short, a few sentences only, and not too much more». Traducción nuestra: la descripción de este producto debería ser más bien corta, solo unas pocas oraciones, y no mucho más.
La versión que recomienda: «Use a 3 to 5 sentence paragraph to describe this product». Traducción nuestra: usa un párrafo de 3 a 5 oraciones para describir este producto.
La diferencia es que la segunda se puede medir. Corto para ti puede ser dos líneas, y para la IA, otra cosa.
Lo mismo pasa con profesional, atractivo o con buen tono. Son palabras que cada quien llena distinto. Cámbialas por algo que se pueda comprobar: el largo, el trato de tú o de usted, una palabra que no quieres o un ejemplo.
La prueba del colega
La regla de Anthropic que abre esta guía sirve como revisión antes de enviar. Lee tu instrucción como si fueras alguien que entró hoy a tu negocio. Si tuvieras que preguntar algo para hacer bien el trabajo, la respuesta a esa pregunta va en la instrucción.
Pasarla no exige escribir mucho. La ayuda de Microsoft para Copilot va en la misma línea: «You can put a little or a lot into a prompt, but all that’s required is a clear goal». Traducción nuestra: puedes poner poco o mucho en un prompt, pero lo único que se requiere es un objetivo claro.
Mi criterio, y va como criterio: en una instrucción para un texto que va a leer un cliente, revisaría tres cosas antes de enviarla. Que diga para quién es. Que diga el largo. Y que traiga los datos que solo yo tengo, como precios, fechas y nombres de producto.
Hay modelos que te toman la palabra
Hay otra razón para escribir claro, y viene de las guías de OpenAI para sus modelos. La de GPT-4.1, del 14 de abril de 2025, dice que ese modelo fue entrenado para «follow instructions more closely and more literally» que sus antecesores. Traducción nuestra: seguir las instrucciones más de cerca y de forma más literal.
La misma guía dice que, para corregir una conducta, casi siempre basta con «a single sentence firmly and unequivocally clarifying your desired behavior». Traducción nuestra: una sola oración que aclare con firmeza y sin ambigüedad la conducta que quieres.
La guía de GPT-5, del 7 de agosto de 2025, agrega una advertencia sobre las contradicciones: «poorly-constructed prompts containing contradictory or vague instructions can be more damaging to GPT-5 than to other models». Traducción nuestra: los prompts mal construidos, con instrucciones contradictorias o vagas, pueden hacerle más daño a GPT-5 que a otros modelos.
Su ejemplo es el asistente de una clínica. En una parte se le dice «Never schedule an appointment without explicit patient consent recorded in the chart». Traducción nuestra: nunca agendes una cita sin el consentimiento explícito del paciente registrado en el expediente. En otra, se le pide asignar el primer horario libre del día sin contactar al paciente.
En un negocio pasa igual, y este ejemplo es inventado. Una instrucción fija pide respuestas de menos de 50 palabras, y la del mensaje pide explicar todo con detalle. La IA tiene que elegir una, y no sabes cuál.
OpenAI marca como archivadas las guías de GPT-4.1 y GPT-5. La de su familia más reciente, GPT-6, va en la misma línea. Dice que GPT-6 Astra «is better able to follow longer instructions, but can also be more sensitive to information in context». Traducción nuestra: sigue mejor las instrucciones largas, pero también puede ser más sensible a la información del contexto.
Y pide «State each instruction once». Traducción nuestra: di cada instrucción una sola vez. Lectura nuestra: vale para cualquier asistente, y si dos instrucciones chocan, decide tú cuál manda. Borra la otra o di de forma explícita cuál tiene prioridad.
Lo que dicen las guías de OpenAI, Anthropic, Google y Microsoft
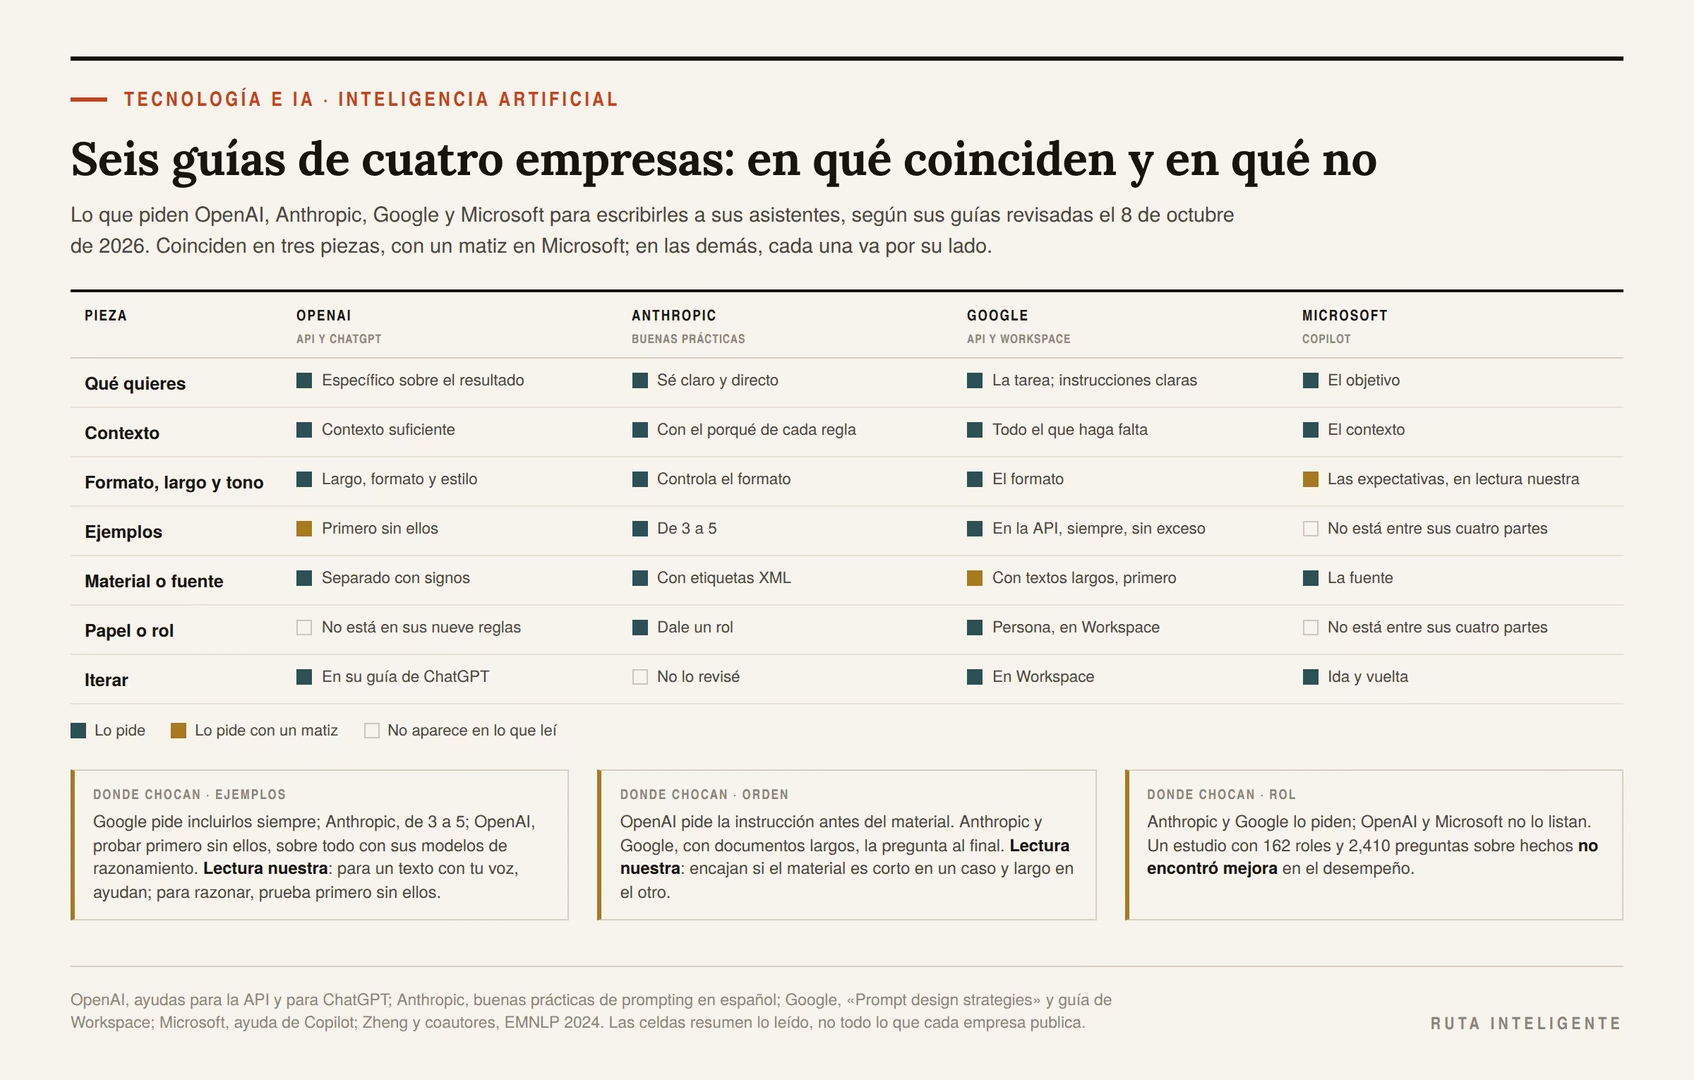
Las cuatro empresas publican cómo escribirles a sus asistentes. Revisé sus guías el 8 de octubre de 2026, y esto es lo que piden.
Cuatro empresas, seis guías
OpenAI tiene dos en su centro de ayuda. La de su API enumera nueve reglas, de «Use the latest model» a «Use the Generate Anything feature». Traducción nuestra: usa el modelo más reciente; usa la función Generate Anything.
La de ChatGPT es más corta y empieza así: «Ensure your prompts are clear, specific, and provide enough context for the model to understand what you are asking». Traducción nuestra: asegúrate de que tus prompts sean claros, específicos y den suficiente contexto para que el modelo entienda lo que pides.
Anthropic publica sus buenas prácticas también en español. El primer apartado de sus principios generales se llama «Sé claro y directo», y empieza con esta frase: «Claude responde bien a instrucciones claras y explícitas».
Google tiene una guía para su API y otra para quien usa Gemini en Workspace. La primera abre con la claridad: «An effective and efficient way to customize model behavior is to provide it with clear and specific instructions». Traducción nuestra: una forma eficaz y eficiente de ajustar el comportamiento del modelo es darle instrucciones claras y específicas.
La de Workspace ordena todo en cuatro áreas: Persona, Task, Context y Format, es decir, el papel que asume la IA, la tarea, el contexto y el formato.
Microsoft lo resume así en su ayuda para Copilot: «Prompts can include four parts: the goal, context, expectations, and source». Traducción nuestra: los prompts pueden incluir cuatro partes, el objetivo, el contexto, las expectativas y la fuente.
En qué coinciden
Lectura nuestra: las guías de las cuatro empresas piden lo mismo en tres puntos, que son decir qué quieres, dar el contexto y pedir un formato. En Microsoft, el formato es nuestra lectura de sus expectativas, que explica en una imagen que no pude leer como texto. Lo demás cambia de una a otra.
| Pieza | OpenAI | Anthropic | Microsoft | |
|---|---|---|---|---|
| Qué quieres | Sí | Sí | Sí, la tarea | Sí, el objetivo |
| Contexto | Sí | Sí, con el porqué | Sí | Sí |
| Formato, largo y tono | Sí | Sí | Sí | Probablemente, en las expectativas (lectura nuestra) |
| Ejemplos | Sí; primero, sin ellos | De 3 a 5 | En la API, siempre, sin exceso | No está entre sus cuatro partes |
| Material o fuente | Separado con signos | Con etiquetas | Con textos largos, el material primero | Sí, la fuente |
| Papel o rol | No está en sus nueve reglas | Sí | Sí, en Workspace | No está entre sus cuatro partes |
| Iterar | Sí, en la guía de ChatGPT | No lo revisé | Sí, en Workspace | Sí |
La tabla resume lo que leí, no todo lo que cada empresa publica.
En qué no coinciden
Los ejemplos. Google, en la guía de su API, es tajante: «We recommend to always include few-shot examples in your prompts». Traducción nuestra: recomendamos incluir siempre algunos ejemplos en tus prompts. Anthropic da un número: «Incluye de 3 a 5 ejemplos para obtener los mejores resultados».
OpenAI va por pasos. Su guía para la API dice «Start with zero-shot, then few-shot, neither of them worked, then fine-tune». Traducción nuestra: empieza sin ejemplos, luego con algunos ejemplos y, si ninguna de las dos funcionó, afina el modelo. Y para sus modelos de razonamiento pide empezar sin ejemplos, como se ve más abajo.
El orden. La guía de OpenAI para la API pide «Put instructions at the beginning of the prompt». Traducción nuestra: pon las instrucciones al principio del prompt. Anthropic y Google, con documentos largos, piden algo que parece lo contrario: el documento primero y la pregunta al final. Lectura nuestra: encajan. Lo explico en «El orden y los separadores».
El papel. Anthropic recomienda darle a Claude un rol, y Google lo pone entre sus cuatro áreas. OpenAI no lo incluye en sus nueve reglas, y Microsoft tampoco entre sus cuatro partes. Un estudio que lo probó con 162 roles está en «Siete mitos sobre las instrucciones».
Mi criterio, y va como criterio: cuando dos guías no coinciden, seguiría la del fabricante del asistente que uso. Y si la tarea se repite cada semana, probaría las dos formas con un caso real antes de quedarme con una.
Lo que ya dijimos en esta serie
«Las mejores herramientas de IA para emprendedores» tiene un apartado, «Cómo pedirle bien las cosas», con cinco consejos. Leídos contra las seis guías, quedan así.
- «Dale el contexto que tú tienes y ella no» coincide con las seis. Su ejemplo de tu voz es lo que Anthropic y Google piden con los ejemplos.
- «Dile qué no quieres» necesita su otra mitad. Las guías de OpenAI y Anthropic piden decir qué hacer en lugar de qué no hacer.
- Lectura nuestra: «Corrige en el mismo hilo» vale para un ajuste o dos. Cuando las correcciones se contradicen, conviene empezar de nuevo, como se explica en «Cuándo empezar de nuevo».
- «Pide opciones, no una respuesta» no aparece en las guías que leí. Puede ser un buen hábito, pero es criterio nuestro, no una regla de ellas.
- «Las señales de que te está inventando algo» se completa con lo que dicen OpenAI y Anthropic sobre las alucinaciones, en «Cuando la respuesta tiene que ser cierta».
Lo que ninguna promete
En lo que leí, ninguna de las seis dice que una buena instrucción garantice una respuesta correcta.
Fuera de esas seis, Anthropic lo escribe en su página sobre alucinaciones: «Remember, while these techniques significantly reduce hallucinations, they don’t eliminate them entirely». Traducción nuestra: recuerda que, aunque estas técnicas reducen mucho las alucinaciones, no las eliminan del todo.
Microsoft pide revisar: «Review and verify responses you get from Copilot». Traducción nuestra: revisa y verifica las respuestas que te da Copilot. Y avisa que la misma instrucción no da siempre lo mismo: «Using the same prompt multiple times can result in different responses». Traducción nuestra: usar el mismo prompt varias veces puede dar respuestas distintas.
Lectura nuestra: la instrucción es la mitad del trabajo. La otra mitad es revisar lo que sale.
Las cinco piezas de una buena instrucción
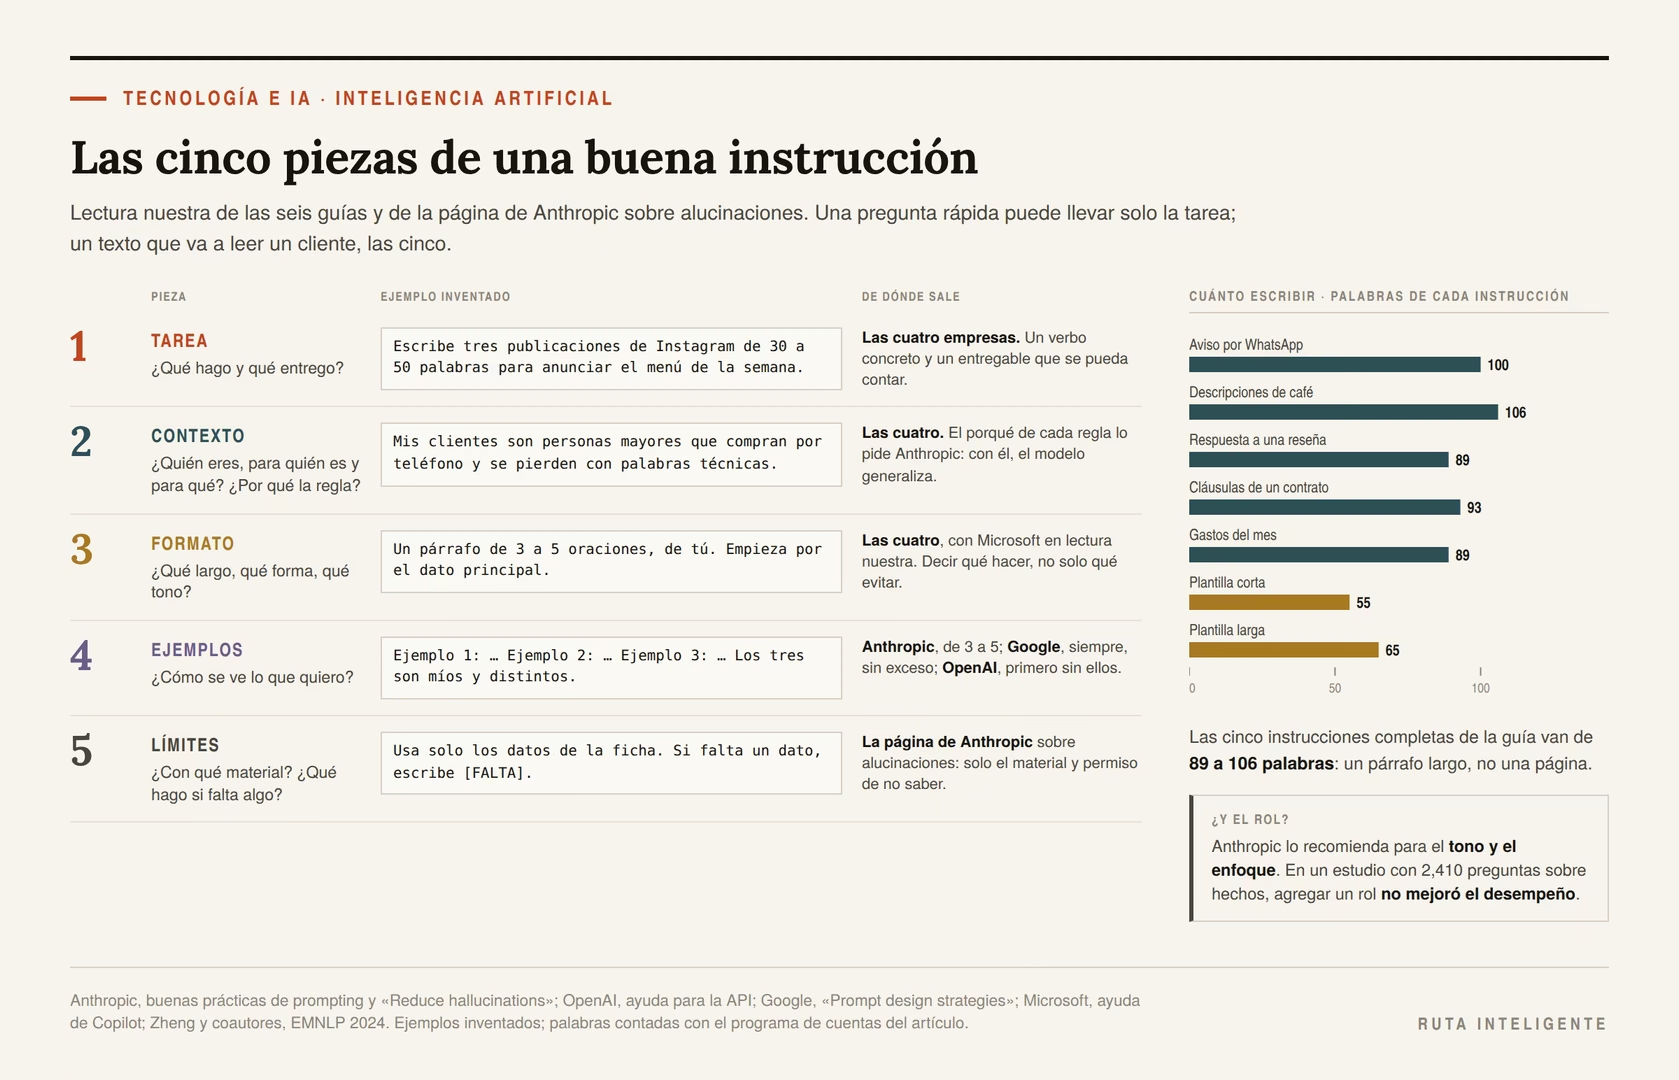
Lectura nuestra de las seis guías y de la página de Anthropic sobre alucinaciones: lo básico cabe en cinco piezas. El rol y las correcciones van aparte. No todas las instrucciones necesitan las cinco. Una pregunta rápida puede llevar solo la tarea; un texto que va a leer un cliente, todas.
1. La tarea: un verbo y un entregable
La tarea dice qué hacer y qué entregar. Anthropic lo plantea así: «Claude responde bien a instrucciones claras y explícitas. Ser específico sobre la salida que deseas puede ayudar a mejorar los resultados».
Google, en su guía para la API, lo dice en una línea: «State your goal clearly and concisely». Traducción nuestra: di tu objetivo con claridad y en pocas palabras.
En la práctica, eso es un verbo concreto y un entregable concreto. Sirven verbos como estos: escribe, resume, clasifica, compara, corrige, traduce, extrae, reescribe. El entregable dice qué sale y cuánto: un mensaje, tres opciones, una tabla de cuatro columnas, una lista de cinco puntos.
Un ejemplo inventado. Ayúdame con mis redes no tiene verbo útil ni entregable. Escribe tres publicaciones de Instagram de 30 a 50 palabras para anunciar el menú de la semana tiene los dos.
Mi criterio, y va como criterio: una instrucción, un entregable. Si quieres el correo, la publicación y el guion del video, pediría primero el correo y, cuando esté bien, los otros dos a partir de él.
2. El contexto: quién eres, para quién y para qué
El contexto responde tres preguntas. Quién eres y qué vendes. Para quién es el resultado y qué sabe ya esa persona. Y para qué lo quieres: qué tiene que pasar después de que lo lea.
Anthropic agrega una cuarta: por qué. Dice que explicar el motivo de una regla, y no solo la regla, «puede ayudar a Claude a comprender mejor tus objetivos y ofrecer respuestas más precisas».
Su ejemplo es una regla de formato. La versión menos eficaz: «NEVER use ellipses». Traducción nuestra: NUNCA uses puntos suspensivos.
La versión que recomienda: «Your response will be read aloud by a text-to-speech engine, so never use ellipses since the text-to-speech engine will not know how to pronounce them». Traducción nuestra: tu respuesta la va a leer en voz alta un motor de texto a voz, así que nunca uses puntos suspensivos, porque el motor no sabrá cómo pronunciarlos.
Y explica por qué funciona: «Claude es lo suficientemente inteligente para generalizar a partir de la explicación». Con el motivo, el modelo puede aplicar la regla a casos que no le escribiste.
En un negocio, el ejemplo inventado sería este. No uses tecnicismos es una regla sin motivo. Esta otra lo trae: mis clientes son personas mayores que compran por teléfono y se pierden con palabras técnicas; escríbelo como se lo explicarías en persona. Con el motivo, la IA puede evitar también tecnicismos que no se te ocurrió mencionar.
3. El formato: largo, forma y tono
El formato tiene tres partes. El largo, en palabras, oraciones o renglones. La forma: un párrafo, una lista, una tabla con columnas definidas. Y el tono: de tú o de usted, cercano o formal, con o sin emojis.
La guía de OpenAI para la API lo pide sin rodeos: «Be specific, descriptive and as detailed as possible about the desired context, outcome, length, format, style, etc». Traducción nuestra: da detalles específicos y descriptivos, tantos como puedas, sobre el contexto, el resultado, el largo, el formato, el estilo, etcétera, que buscas.
Las guías de OpenAI y Anthropic piden además decir qué hacer, y no solo qué evitar. OpenAI lo pone como regla: «Instead of just saying what not to do, say what to do instead». Traducción nuestra: en lugar de solo decir qué no hacer, di qué hacer.
Su ejemplo es un asistente de soporte. La versión menos eficaz: «DO NOT ASK USERNAME OR PASSWORD. DO NOT REPEAT». Traducción nuestra: NO PREGUNTES EL USUARIO NI LA CONTRASEÑA. NO REPITAS.
La versión que recomienda le dice al agente qué hacer en su lugar, y termina así: «Instead of asking for PII, such as username or password, refer the user to the help article www.samplewebsite.com/help/faq». Traducción nuestra: en lugar de pedir datos personales que permitan identificarlo, como el usuario o la contraseña, remite al usuario al artículo de ayuda www.samplewebsite.com/help/faq. Anthropic lo dice en español: «Dile a Claude qué hacer en lugar de qué no hacer».
En «Dile qué no quieres», de «Las mejores herramientas de IA para emprendedores», propusimos una lista de lo que no quieres. Lectura nuestra: conviene acompañar cada no de su sí. Dos ejemplos inventados: en lugar de sin introducción, empieza por el dato principal; en lugar de nada de rollo, máximo 80 palabras.
4. Los ejemplos: muestra en vez de describir
Un ejemplo enseña lo que una descripción no alcanza a decir: el ritmo, el largo, las palabras que usas. Anthropic da un número: «Incluye de 3 a 5 ejemplos para obtener los mejores resultados». También pide que sean variados y que vayan marcados como ejemplos, para que el modelo no los confunda con instrucciones.
Google va más lejos en su guía para la API: «We recommend to always include few-shot examples in your prompts». Traducción nuestra: recomendamos incluir siempre algunos ejemplos en tus prompts. Y lo justifica: «Prompts without few-shot examples are likely to be less effective». Traducción nuestra: los prompts sin ejemplos probablemente serán menos eficaces.
La misma guía avisa del riesgo contrario: «if you include too many examples, the model may start to overfit the response to the examples». Traducción nuestra: si incluyes demasiados ejemplos, el modelo puede empezar a ajustar la respuesta de más a los ejemplos. Lectura nuestra: en la práctica, a calcarlos.
En un negocio, los ejemplos ya los tienes. Mensajes que mandaste y funcionaron, descripciones que te gustan, respuestas a clientes que no tuviste que corregir. Pégalos con una etiqueta clara, como Ejemplo 1 y Ejemplo 2, y di qué tienen en común que quieres conservar.
Mi criterio, y va como criterio: empezaría con tres ejemplos reales, distintos entre sí en tema. Si los tres se parecen demasiado, la IA va a copiar lo que tienen en común, y eso puede incluir lo que no querías.
5. Los límites: qué material usar y qué hacer si falta algo
Los límites dicen con qué trabajar y qué hacer cuando la información no alcanza. Esta pieza no está entre las cuatro áreas de Google ni entre las cuatro partes de Microsoft, aunque la cuarta, la fuente, se le acerca. Viene de la página de Anthropic sobre cómo reducir alucinaciones.
De esa página salen dos de sus técnicas. Una: «Explicitly instruct Claude to only use information from provided documents and not its general knowledge». Traducción nuestra: indícale explícitamente a Claude que use solo la información de los documentos que le das y no su conocimiento general.
La otra: «Explicitly give Claude permission to admit uncertainty». Traducción nuestra: dale permiso explícito a Claude de admitir que no está seguro.
En una instrucción de negocio, eso cabe en tres líneas inventadas.
- Usa solo los datos de la ficha.
- Si falta un dato, escribe [FALTA] en su lugar.
- Si te falta información para hacerlo bien, pregúntame antes de escribir.
¿Y el rol?
Hay quien empieza cada instrucción con eres un experto en…. Anthropic recomienda dar un rol, para un uso concreto. Dice que fijar un rol en las instrucciones del sistema «enfoca el comportamiento y el tono de Claude para tu caso de uso». Y agrega: «Incluso una sola oración marca la diferencia».
Google lo pone primero entre sus cuatro áreas, con el nombre de Persona.
Pero un estudio de 2024 probó 162 roles distintos con 2,410 preguntas sobre hechos, y agregar un rol no mejoró el desempeño. Lo cuento en «Siete mitos sobre las instrucciones». Lectura nuestra: el rol sirve para el tono y el enfoque; no le da a la IA conocimientos que no tiene.
Cuánto escribir
Las cinco instrucciones completas de «Cinco instrucciones, antes y después» tienen entre 89 y 106 palabras. Es un párrafo largo, no una página. Y la plantilla corta del final, con sus espacios en blanco, tiene 55.
Ese largo alcanzó para meter las cinco piezas en las tareas de este artículo. Y si la tarea es tan corta que explicarla toma más que hacerla, no conviene escribir la instrucción: es el caso de lo que es más rápido hacer que explicar.
El orden y los separadores
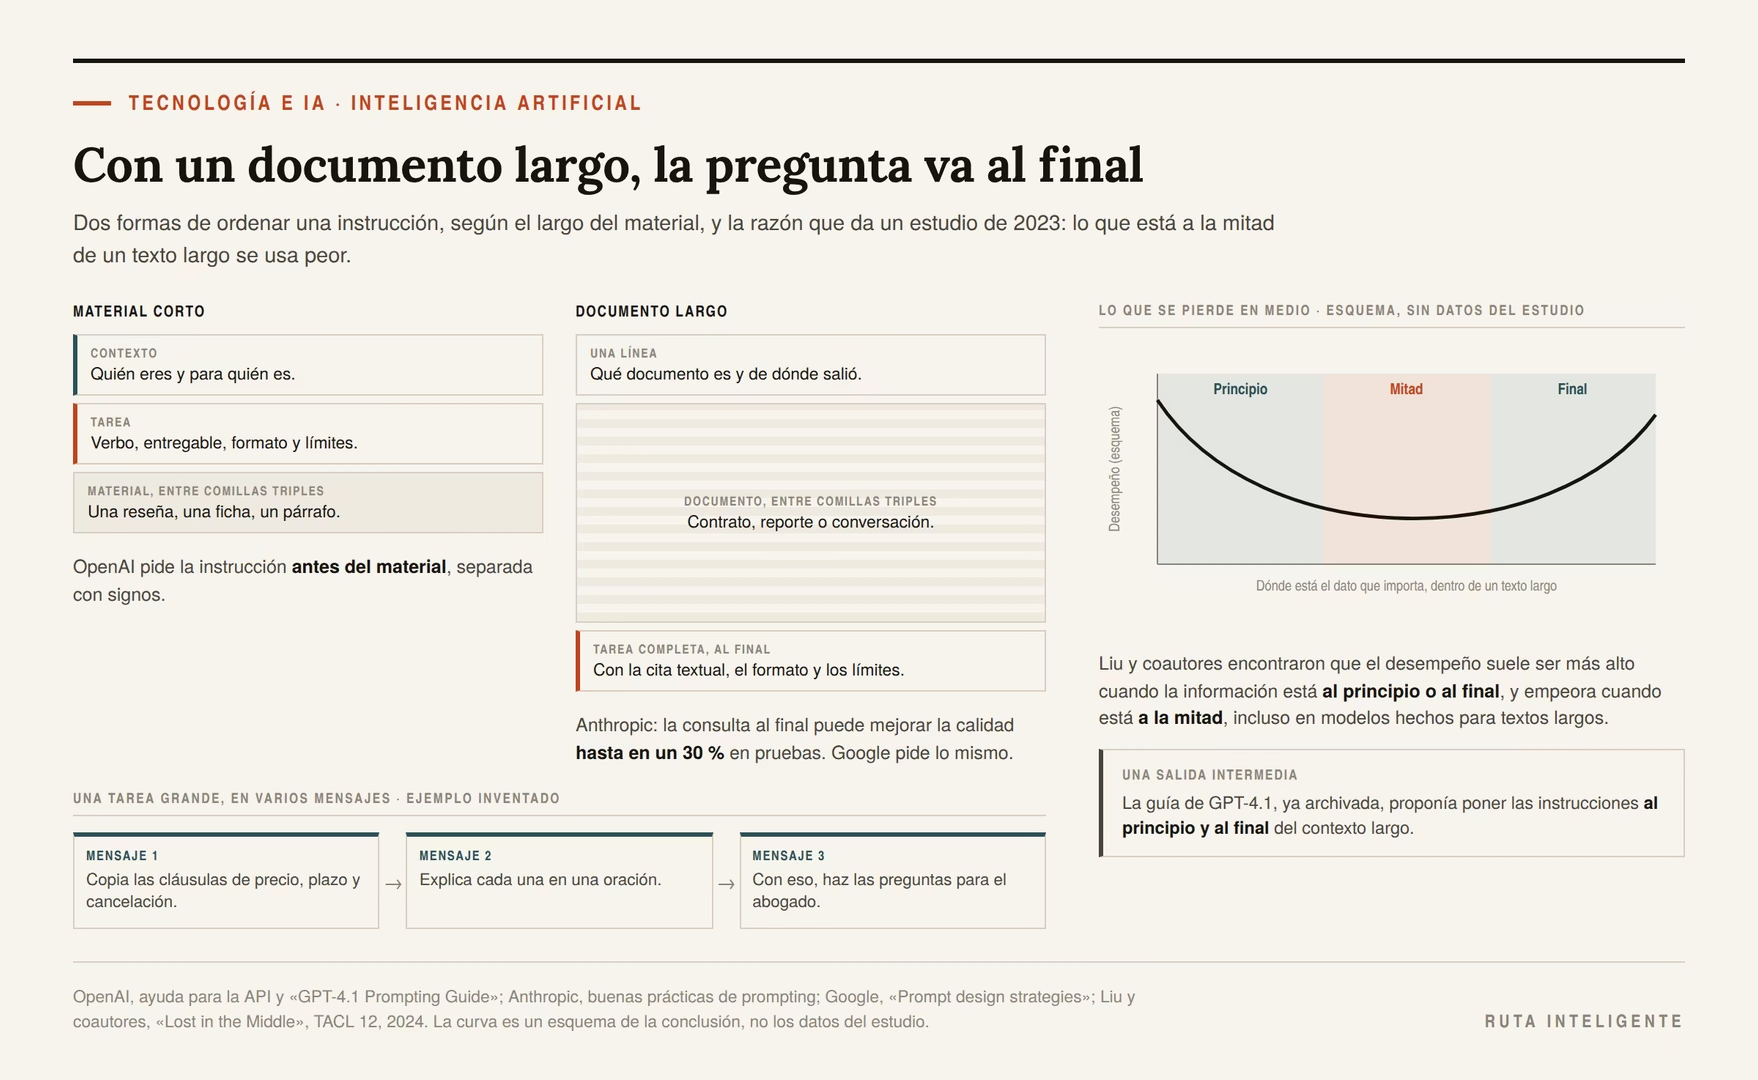
La guía de OpenAI pide la instrucción antes del material. Con un documento largo, Anthropic y Google piden otro orden, y un estudio de 2023 ayuda a entender por qué.
Separa la instrucción del material
Cuando pegas un texto para que la IA trabaje con él, conviene que se vea dónde empieza y dónde termina. La segunda regla de la guía de OpenAI para la API pide separar la instrucción del material con signos como tres almohadillas o tres comillas.
Anthropic propone etiquetas XML, con un nombre para cada parte, para que el modelo distinga instrucciones, contexto, ejemplos y material. En un asistente de chat no hace falta tanto. Tres comillas antes y después del texto, o una etiqueta como Material: en su propia línea, cumplen la misma función.
Tres de las cinco instrucciones de la sección siguiente usan tres comillas, y la de la reseña usa una etiqueta en su propia línea. Lo que va entre comillas, o después de la etiqueta, es material; lo demás es la instrucción.
Con documentos largos, la pregunta va al final
Aquí Anthropic y Google coinciden, y su consejo parece el contrario de la regla de OpenAI. Anthropic dice: «Ubica tus documentos largos y entradas cerca del inicio de tu prompt, por encima de tu consulta, instrucciones y ejemplos».
Y da una cifra: «Las consultas al final pueden mejorar la calidad de la respuesta hasta en un 30 por ciento en pruebas, especialmente con entradas complejas de múltiples documentos». En lo que leí, la página no explica cómo se hicieron esas pruebas.
La sección sobre Gemini 3 de la guía de Google para su API pide lo mismo: «Place your specific instructions or questions at the very end of the prompt». Traducción nuestra: pon tus instrucciones o preguntas específicas justo al final del prompt.
La guía de GPT-4.1, ya archivada, proponía una salida intermedia para cuando el contexto es largo: «ideally place your instructions at both the beginning and end of the provided context». Traducción nuestra: lo ideal es poner tus instrucciones tanto al principio como al final del contexto que proporcionas.
Lectura nuestra: las dos reglas encajan si se aplican a casos distintos. Con un material corto, la instrucción puede ir antes. Con un documento largo, el documento va arriba y la tarea completa abajo. El contexto sobre ti puede abrir en los dos casos, como en la plantilla corta.
Mi criterio, y va como criterio: con un contrato, un reporte o una conversación larga, pondría tres bloques. Arriba, una línea que diga qué es. En medio, el documento. Al final, la tarea completa, con el formato y los límites. Es el orden de la plantilla larga de esta guía.
Lo que se pierde en medio
En 2023, siete investigadores encabezados por Nelson F. Liu midieron qué tan bien usan los modelos la información según dónde está en un texto largo. El estudio se publicó en 2024 en la revista Transactions of the Association for Computational Linguistics.
Encontró que el desempeño «is often highest when relevant information occurs at the beginning or end of the input context». Traducción nuestra: suele ser más alto cuando la información relevante aparece al principio o al final del texto de entrada. Y que «significantly degrades when models must access relevant information in the middle of long contexts». Traducción nuestra: empeora de forma significativa cuando los modelos tienen que usar información relevante que está a la mitad de textos largos.
Lo encontró, dice, «even for explicitly long-context models». Traducción nuestra: incluso en modelos hechos expresamente para textos largos.
Los modelos de ese estudio ya tienen sucesores, y no sé cuánto afecta ese efecto a los de hoy. Pero las guías vigentes de Anthropic y Google siguen pidiendo el documento arriba y la pregunta abajo.
Lectura nuestra para un negocio: si el dato que te importa está en la página 20 de un contrato de 40, no confíes en que la IA lo encuentre sola. Pídele que copie primero el texto exacto de las cláusulas que buscas, como se ve en «Pide la cita textual».
Una tarea grande, en varios mensajes
Google recomienda dividir. Lo dice así en su guía para la API: «Instead of having many instructions in one prompt, create one prompt per instruction». Traducción nuestra: en lugar de tener muchas instrucciones en un prompt, crea un prompt por instrucción. Para tareas de varios pasos, propone hacer de cada paso un prompt y encadenarlos. Anthropic dedica una sección de su guía a lo mismo: encadenar prompts complejos.
Un ejemplo inventado con un contrato. Primer mensaje: copia las cláusulas de precio, plazo y cancelación. Segundo: explica cada una en una oración. Tercero: con base en eso, haz una lista de preguntas para el abogado. Cada paso se revisa antes de pasar al siguiente. Así, un error del primero no llega al último sin que lo veas. Si el contrato es corto, cabe en un solo mensaje, como en «Las cláusulas de un contrato antes de firmar».
Cinco instrucciones, antes y después
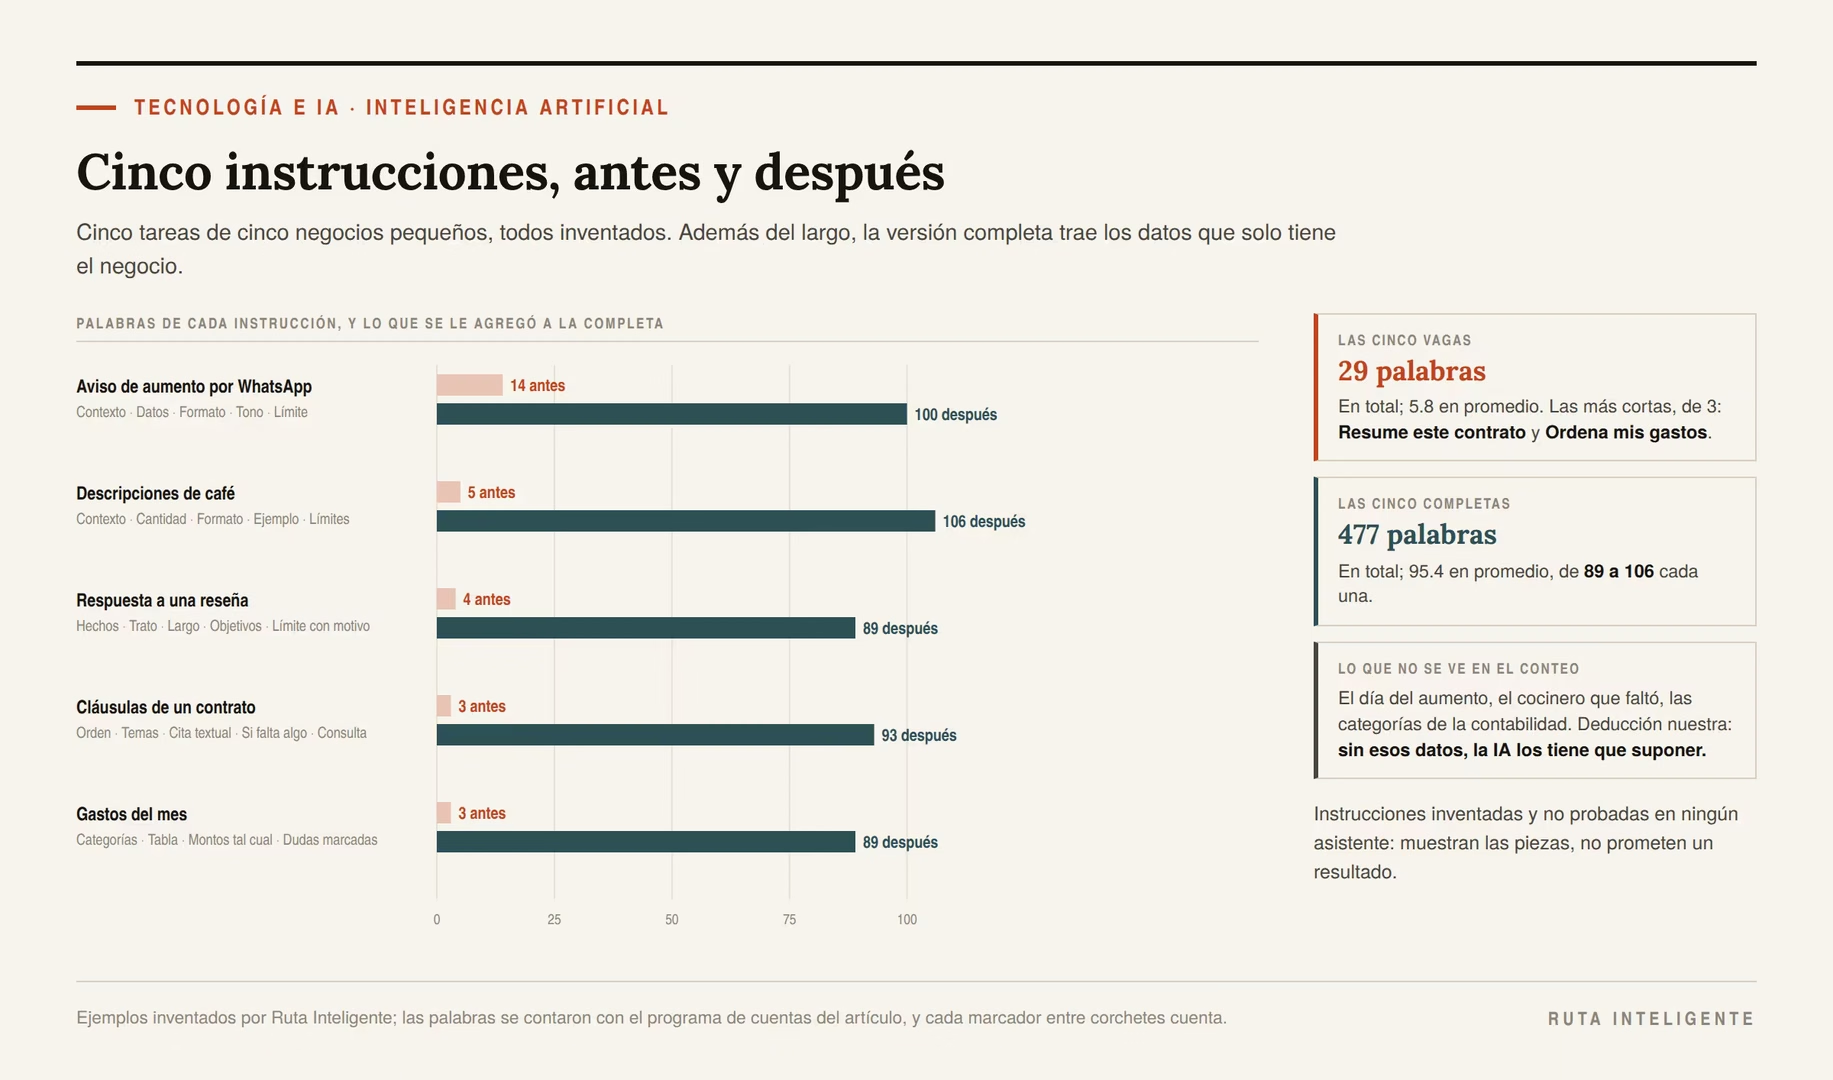
Cinco tareas de cinco negocios pequeños, cada una con su instrucción vaga y su instrucción completa. Todo es inventado: los negocios, los datos y las instrucciones. No las probé en ningún asistente; sirven para ver las cinco piezas en uso, no prometen un resultado. Las palabras están contadas con el mismo programa que hace las cuentas del artículo.
Un aviso de aumento de precio por WhatsApp
Una panadería de barrio en Puebla va a subir el pan dulce. Así se ve la instrucción vaga, de 14 palabras.
Escribe un mensaje para avisar a mis clientes que vamos a subir los precios.
Y así, la completa, de 100 palabras.
Tengo una panadería de barrio en Puebla. Mis clientes son vecinos que compran pan dulce casi a diario y me conocen por mi nombre.
Escribe un mensaje de WhatsApp para avisarles que el lunes 9 de noviembre el pan dulce sube de 10 a 12 pesos, porque la harina y el gas subieron.
Tono: cercano y respetuoso, de tú, como les hablo en el mostrador. Sin disculpas largas ni signos de admiración.
Formato: un solo mensaje de 40 a 60 palabras, sin emojis, que cierre con una línea para apartar pedidos.
Si te falta algún dato para escribirlo, pregúntamelo antes.
Qué cambió. El contexto dice quién vende y a quién: vecinos que conocen a la panadera por su nombre. La tarea trae el canal y los datos que solo ella tiene: el día, el precio de antes, el nuevo y el motivo. La línea de tono fija el trato, y la de formato, el largo y el cierre. Y el límite le pide a la IA preguntar antes de suponer lo que falte.
Fíjate en el precio y la fecha. Deducción nuestra: si no van en la instrucción, el mensaje sale sin ellos o con datos que la IA tuvo que suponer, y en los dos casos hay que corregirlo antes de mandarlo.
Descripciones para una tienda en línea
Una tienda en línea de café de Coatepec, Veracruz, necesita describir tres cafés nuevos. La instrucción vaga tiene 5 palabras.
Hazme descripciones para mis cafés.
La completa tiene 106.
Vendo café de especialidad de Coatepec, Veracruz, en mi tienda en línea. Mis clientes preparan café en casa, con prensa francesa o cafetera de goteo.
Escribe una descripción para cada uno de los tres cafés cuyas fichas pego abajo, entre comillas triples.
Cada descripción: un párrafo de 3 a 5 oraciones, de tú, sin frases como "el mejor del mundo" o "único".
Usa solo los datos de la ficha. Si falta un dato, como la altura o el proceso, escribe [FALTA] en su lugar.
Este es un ejemplo de una descripción que ya publiqué y me gusta: [pega aquí tu descripción].
"""
[pega aquí las tres fichas]
«»»
Qué cambió. El contexto dice cómo preparan café sus clientes, y eso orienta la descripción hacia lo que les sirve. La tarea fija cuántas descripciones son. El formato pide un párrafo de 3 a 5 oraciones, el mismo largo del ejemplo de OpenAI. La prohibición de los superlativos va junto a lo que sí se pide. Y hay dos límites: usar solo la ficha y marcar con [FALTA] lo que no esté en ella, para que lo encuentres con el buscador del documento antes de publicar.
El ejemplo de una descripción propia es la pieza que le enseña a la IA tu voz. Aquí va uno para no alargar la instrucción; si tienes tres distintos, pega los tres. Y si no tienes ninguno que te guste, escribe uno a mano antes de pedir los demás.
Una buena descripción no sustituye a una buena oferta. El precio, la garantía y lo que incluye cada paquete se deciden antes de escribir, y eso está en cómo armar una oferta para tus clientes.
La respuesta a una reseña negativa
Una fonda en Guadalajara recibió en Google una reseña negativa por una espera larga. La instrucción vaga tiene 4 palabras.
Contesta esta reseña negativa.
La completa tiene 89.
Tengo una fonda en Guadalajara. Una clienta dejó en Google la reseña que pego abajo: dice que esperó 40 minutos su comida y que nadie le explicó por qué.
Tiene razón. Ese sábado faltó un cocinero, y ya contratamos a otra persona para los fines de semana.
Escribe una respuesta pública de 50 a 80 palabras, de usted, que reconozca la espera sin dar excusas, cuente el cambio y la invite a volver.
No ofrezcas descuentos ni regalos, porque no los vamos a dar.
Reseña: [pega aquí la reseña].
Qué cambió. La instrucción trae los hechos: qué pasó, que la clienta tiene razón y qué se corrigió. Fija el trato de usted para una respuesta pública, el largo y las tres cosas que debe lograr: reconocer la espera, contar el cambio e invitar a volver. Y pone un límite con su motivo: no ofrecer descuentos, porque no los van a dar.
Deducción nuestra: sin ese límite, una disculpa redactada por la IA puede prometer algo que el negocio no va a cumplir, y la promesa queda publicada.
Contestar bien una reseña es parte de conservar a un cliente. Lo que vale conservarlo se calcula en cuánto vale un cliente.
Las cláusulas de un contrato antes de firmar
Una tienda pequeña recibió el contrato de un proveedor de empaques. La instrucción vaga tiene 3 palabras.
Resume este contrato.
La completa tiene 93.
Abajo, entre comillas triples, va el contrato que me envió un proveedor de empaques. Tengo una tienda pequeña y no estudié derecho.
"""
[pega aquí el contrato, sin nombres ni datos bancarios]
«»» Haz una lista de las cláusulas sobre precio, plazo de entrega, penalizaciones, renovación automática y cancelación. Para cada una, copia el texto exacto del contrato y explícalo después en una oración sencilla. Si el contrato no trata alguno de esos temas, escribe: No aparece en el contrato. En lugar de darme una opinión legal, marca lo que debería preguntarle a un abogado.
Qué cambió. El contrato va arriba y la tarea abajo, como piden Anthropic y Google para documentos largos. La lista de temas es cerrada, así que la IA no decide qué te importa. Cada cláusula se copia tal cual antes de explicarse, que es lo que Anthropic recomienda para poder revisar la respuesta contra el original. Hay una salida para lo que no aparece. Y en lugar de pedir una opinión legal, se pide marcar qué consultar.
El contrato va sin nombres ni datos bancarios. Qué cláusulas conviene revisar, y por qué, está en las cláusulas de un contrato con proveedores. Información general, no asesoría legal: la IA te ayuda a leer, y la decisión de firmar se consulta con un abogado.
Los gastos del mes, clasificados
Un negocio quiere ordenar los movimientos de septiembre de su cuenta. La instrucción vaga tiene 3 palabras.
Ordena mis gastos.
La completa tiene 89.
Abajo, entre comillas triples, van los movimientos de septiembre de la cuenta de mi negocio, sin números de cuenta ni nombres de personas.
"""
[pega aquí los movimientos]
«»» Clasifica cada movimiento en una de estas categorías: insumos, renta, nómina, servicios, comisiones, impuestos u otros. Devuélvelo en una tabla de cuatro columnas: fecha, concepto, monto y categoría. Copia los montos tal como vienen. Si no sabes dónde va un movimiento, ponlo en otros y márcalo con un signo de interrogación. No hagas sumas: las hago yo en mi hoja de cálculo.
Qué cambió. Las categorías son una lista cerrada, así que la IA no inventa las suyas. La tabla tiene sus columnas definidas, y los montos se copian tal como vienen. Lo dudoso queda marcado para que lo revises tú. Y no hay sumas. Lectura nuestra: en la hoja de cálculo, una fórmula suma sin error, y revisar una suma hecha por la IA toma casi lo mismo que hacerla.
Los movimientos van sin números de cuenta ni nombres de personas. Qué rubros conviene revisar cada mes está en los gastos que conviene revisar cada mes.
Lo que cambió en las cinco
Las cinco instrucciones vagas suman 29 palabras, 5.8 en promedio. Las completas suman 477, 95.4 en promedio, y van de 89 a 106.
| Tarea | Palabras antes | Palabras después | Lo que se agregó |
|---|---|---|---|
| Aviso de aumento por WhatsApp | 14 | 100 | Contexto, datos del aumento, formato, tono y un límite |
| Descripciones de café | 5 | 106 | Contexto, cantidad, formato, un ejemplo y dos límites |
| Respuesta a una reseña | 4 | 89 | Hechos, trato, largo, tres objetivos y un límite con motivo |
| Cláusulas de un contrato | 3 | 93 | Orden, temas, cita textual, salida si falta algo y consulta |
| Gastos del mes | 3 | 89 | Categorías cerradas, tabla, montos tal cual y dudas marcadas |
Mi criterio, y va como criterio: lo que no dejaría fuera, sea cual sea la pieza, es el dato que solo tiene el negocio. El precio nuevo, el cocinero que faltó, las categorías de su contabilidad. Si una instrucción no trae ninguno, la escribiría de nuevo antes de enviarla.
Deja fijo lo que repites
Si cada vez que abres el asistente le explicas quién eres y cómo escribes, puedes dejarlo escrito una sola vez. ChatGPT, Claude y Gemini tienen un lugar para eso, con nombres distintos.
Instrucciones personalizadas en ChatGPT
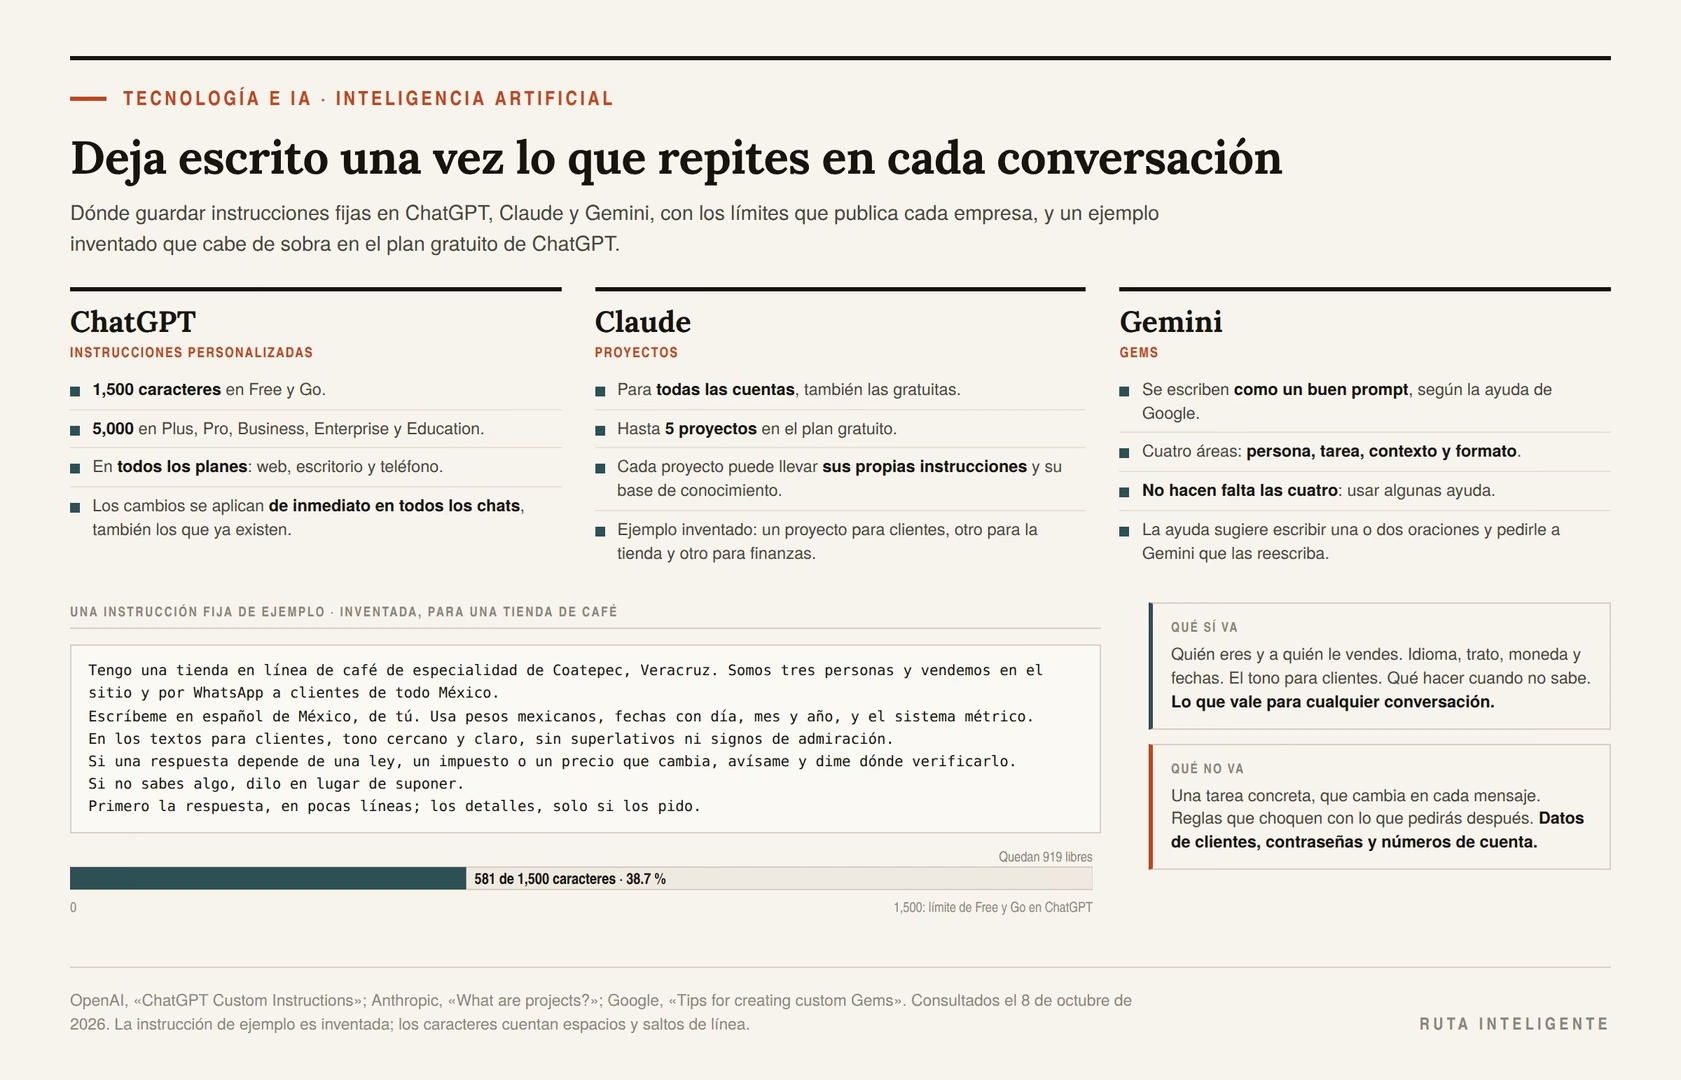
OpenAI las define así: «Custom instructions allow you to share anything you’d like ChatGPT to consider in its response». Traducción nuestra: las instrucciones personalizadas te permiten compartir lo que quieras que ChatGPT tome en cuenta al responder. Están en la configuración, en el apartado de personalización.
Tienen un límite de largo según el plan. «Free and Go users can save up to 1,500 characters in custom instructions». Traducción nuestra: los usuarios de Free y Go pueden guardar hasta 1,500 caracteres en las instrucciones personalizadas. Y «Plus, Pro, Enterprise, Business, and Education users can save up to 5,000 characters». Traducción nuestra: los usuarios de Plus, Pro, Enterprise, Business y Education pueden guardar hasta 5,000 caracteres.
La ayuda agrega dos datos. Están en todos los planes, en la web, en la aplicación de escritorio y en el teléfono. Y los cambios «are applied immediately across all chats». Traducción nuestra: se aplican de inmediato en todos los chats. La ayuda aclara entre paréntesis que eso incluye las conversaciones que ya existen.
Proyectos en Claude
Anthropic lo resuelve con proyectos: «Projects allow you to create self-contained workspaces with their own chat histories and knowledge bases». Traducción nuestra: los proyectos te permiten crear espacios de trabajo independientes, con su propio historial de chats y su propia base de conocimiento.
Cada proyecto puede llevar sus instrucciones: «In addition, you can define project instructions for each project to further tailor Claude’s responses». Traducción nuestra: además, puedes definir instrucciones para cada proyecto para ajustar todavía más las respuestas de Claude.
Sirve para separar trabajos. En un caso inventado, un proyecto para atención a clientes, otro para la tienda en línea y otro para las finanzas. «Projects are available to all users, including those with free Claude accounts». Traducción nuestra: los proyectos están disponibles para todos los usuarios, incluidos los de cuentas gratuitas. Con un límite: «Free users can create a maximum of five projects». Traducción nuestra: los usuarios del plan gratuito pueden crear como máximo cinco proyectos. Qué más se puede hacer sin pagar está en herramientas gratis para emprendedores.
Gems en Gemini
Google llama Gems a sus asistentes con instrucciones guardadas. Su ayuda dice que se escriben igual que un buen prompt: «The main areas to consider when writing good Gem instructions are the same as writing good prompts». Traducción nuestra: las áreas principales a considerar al escribir buenas instrucciones para un Gem son las mismas que al escribir buenos prompts.
Son las cuatro de Workspace, con una línea cada una. Persona: «Tell your Gem what role to play and how to respond». Traducción nuestra: dile a tu Gem qué papel desempeñar y cómo responder. Tarea: «Tell the Gem what you want Gemini to do or create». Traducción nuestra: dile al Gem qué quieres que Gemini haga o cree.
Contexto: «Provide as much background as possible». Traducción nuestra: da todos los antecedentes que puedas. Formato: «Be specific when specifying desired structure». Traducción nuestra: precisa bien la estructura que quieres.
Y una aclaración útil: «You don’t need to use all four, but using a few will help». Traducción nuestra: no necesitas usar las cuatro, pero usar algunas ayuda. La misma ayuda sugiere escribir una o dos oraciones y pedirle a Gemini que las reescriba antes de revisarlas tú.
Qué poner y qué no en una instrucción fija
Este es un ejemplo inventado, para la tienda de café de la sección anterior.
Tengo una tienda en línea de café de especialidad de Coatepec, Veracruz. Somos tres personas y vendemos en el sitio y por WhatsApp a clientes de todo México.
Escríbeme en español de México, de tú. Usa pesos mexicanos, fechas con día, mes y año, y el sistema métrico.
En los textos para clientes, tono cercano y claro, sin superlativos ni signos de admiración.
Si una respuesta depende de una ley, un impuesto o un precio que cambia, avísame y dime dónde verificarlo.
Si no sabes algo, dilo en lugar de suponer.
Primero la respuesta, en pocas líneas; los detalles, solo si los pido.
Tiene 581 caracteres y 103 palabras. Ocupa 38.7 % del límite de 1,500 del plan gratuito de ChatGPT, y deja 919 libres.
Fíjate en lo que trae. Quién es el negocio y a quién le vende. El idioma, el trato, la moneda y el formato de fechas. El tono para clientes. Qué hacer cuando la respuesta depende de algo que cambia, y qué hacer cuando no sabe. Y cómo quiere las respuestas.
Y en lo que no trae. Nada de una tarea concreta, porque cambia en cada conversación. Nada que choque con lo que vas a pedir después; si un día necesitas una respuesta larga, dilo en el mensaje y aclara que manda sobre la instrucción fija. Y nada de datos de clientes, contraseñas ni números de cuenta.
Mi criterio, y va como criterio: en la instrucción fija pondría solo lo que vale para cualquier conversación. Quién soy, cómo escribo y qué hacer cuando la IA no sabe. Lo de cada tarea va en cada mensaje.
Los modelos que razonan piden instrucciones más cortas
Algunos asistentes ofrecen un modo o un modelo que piensa antes de responder. OpenAI los llama modelos de razonamiento, y tiene una guía aparte para escribirles. Lo que pide choca, en parte, con consejos que siguen circulando.
Qué recomienda OpenAI para esos modelos
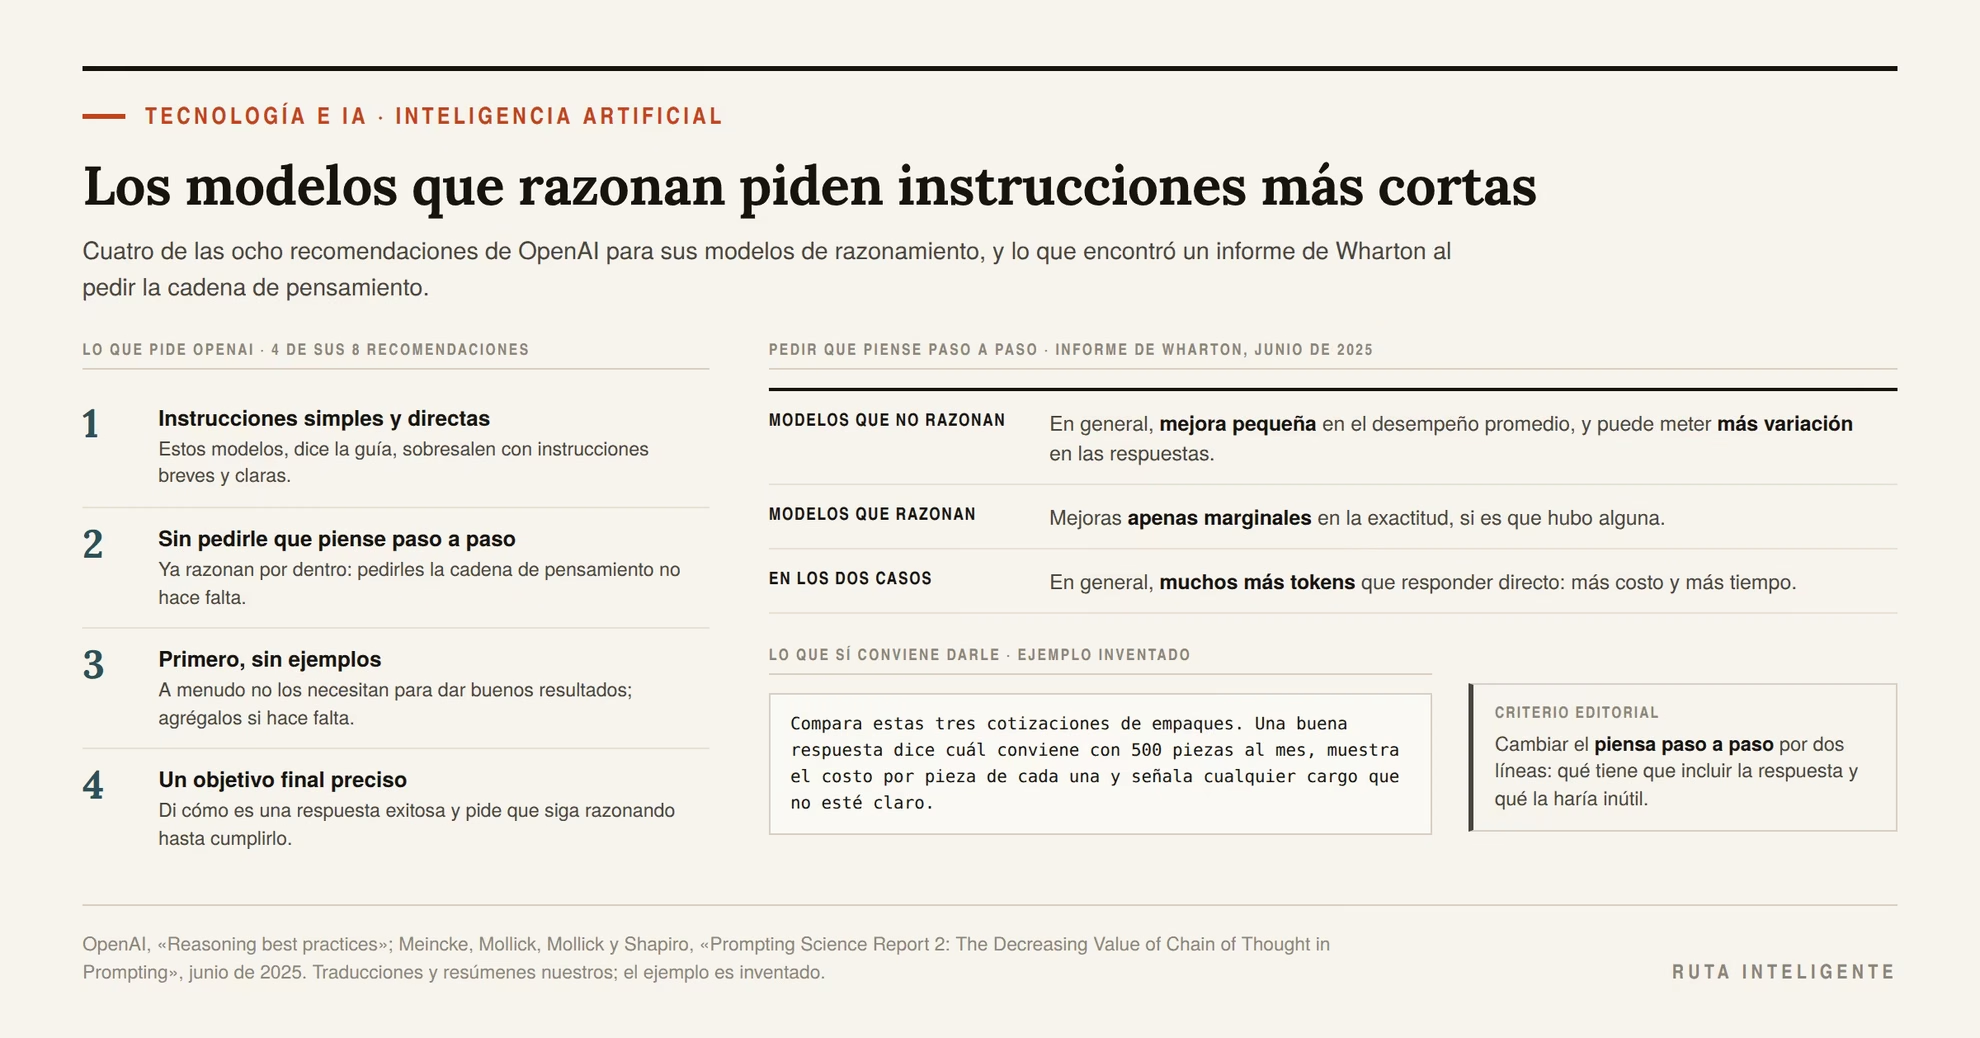
La guía hace ocho recomendaciones, y cuatro tocan lo que trata este artículo. Una es «Keep prompts simple and direct». Traducción nuestra: mantén los prompts simples y directos. La explica así: «The models excel at understanding and responding to brief, clear instructions». Traducción nuestra: estos modelos sobresalen al entender y responder a instrucciones breves y claras.
Otra es «Avoid chain-of-thought prompts». Traducción nuestra: evita los prompts de cadena de pensamiento. Como estos modelos razonan por dentro, dice la guía, pedirles que piensen paso a paso o que expliquen su razonamiento no hace falta.
Otra toca los ejemplos: «Reasoning models often don’t need few-shot examples to produce good results, so try to write prompts without examples first». Traducción nuestra: los modelos de razonamiento a menudo no necesitan ejemplos para dar buenos resultados, así que intenta primero escribir prompts sin ejemplos.
Y otra pide lo que sí conviene darles: «Be very specific about your end goal». Traducción nuestra: precisa al máximo tu objetivo final. La guía sugiere dar los parámetros de una respuesta exitosa y pedirle al modelo que siga razonando hasta cumplirlos.
Pedirle que piense paso a paso
Pedirle a la IA que piense paso a paso sigue apareciendo como consejo; una de las páginas en español que revisé para este artículo lo incluye. El laboratorio de IA generativa de la Wharton School lo midió en un informe de junio de 2025. El resultado fue modesto.
El informe lo resume así: «For non-reasoning models, CoT generally improves average performance by a small amount». Traducción nuestra: en los modelos que no razonan, la cadena de pensamiento en general mejora el desempeño promedio por un margen pequeño. Tiene una contra. Según el informe, «CoT can introduce more variability in answers». Traducción nuestra: la cadena de pensamiento puede meter más variación en las respuestas.
Con los modelos que razonan, pedir la cadena de pensamiento dio, en el resumen del informe, «only marginal, if any, gains in answer accuracy». Traducción nuestra: mejoras apenas marginales en la exactitud de las respuestas, si es que hubo alguna.
Y cuesta más: «Performing CoT generally requires far more tokens (increasing cost and time) than direct answers». Traducción nuestra: hacer cadena de pensamiento en general requiere muchos más tokens, con más costo y más tiempo, que responder directo.
Lectura nuestra: con los modelos que probó el informe, el truco aportó poco y costó tiempo. Las cinco piezas tienen más respaldo en las guías.
Lo que sí conviene darle
Lectura nuestra: un modelo que razona necesita lo mismo que cualquiera, que es la tarea, el contexto, el formato, el material y los límites. Lo que sobra son las instrucciones sobre cómo pensar.
La guía de OpenAI insiste en el objetivo: que el modelo sepa cuándo una respuesta está bien. Un ejemplo inventado para elegir proveedor. Compara estas tres cotizaciones de empaques. Una buena respuesta dice cuál conviene con 500 piezas al mes, muestra el costo por pieza de cada una y señala cualquier cargo que no esté claro.
Mi criterio, y va como criterio: con un modelo que razona, cambiaría el piensa paso a paso por dos líneas. Una que diga qué tiene que incluir la respuesta, y otra que diga qué la haría inútil.
Cuando la respuesta tiene que ser cierta
Una buena instrucción mejora la respuesta. No la vuelve verdadera. Esta sección es para las tareas donde un dato equivocado cuesta: un precio, una fecha, un artículo de ley, una cifra que vas a publicar.
Por qué inventa
OpenAI publicó en septiembre de 2025 una explicación de por qué los modelos de lenguaje inventan. Empieza con una definición: «Hallucinations are plausible but false statements generated by language models». Traducción nuestra: las alucinaciones son afirmaciones plausibles pero falsas generadas por modelos de lenguaje.
La causa que propone está en cómo se entrenan y se califican los modelos: «standard training and evaluation procedures reward guessing over acknowledging uncertainty». Traducción nuestra: los procedimientos habituales de entrenamiento y evaluación premian adivinar por encima de reconocer la incertidumbre.
Su ejemplo es la fecha de nacimiento de uno de los autores. Le preguntaron a un asistente. Lo cuentan así: «When we asked for his birthday, it gave three different dates, likewise all wrong». Traducción nuestra: cuando le preguntamos su cumpleaños, dio tres fechas distintas, todas igualmente equivocadas.
Y pone un límite: «Accuracy will never reach 100%». Traducción nuestra: la exactitud nunca llegará al 100 %. Entre otras razones, porque «some real-world questions are inherently unanswerable». Traducción nuestra: algunas preguntas del mundo real no tienen respuesta por naturaleza.
Microsoft dice algo parecido. En su ayuda para Copilot avisa: «Occasionally, Copilot responses can include incorrect content, due to the vast and diverse nature of LLMs». Traducción nuestra: a veces, las respuestas de Copilot pueden incluir contenido incorrecto, debido a la naturaleza vasta y diversa de los modelos de lenguaje.
Dale permiso de decir que no sabe
Si el entrenamiento premia adivinar, la instrucción puede pedir lo contrario. La página de Anthropic para reducir alucinaciones lo pone primero: «Explicitly give Claude permission to admit uncertainty». Traducción nuestra: dale permiso explícito a Claude de admitir que no está seguro.
En una instrucción, eso cabe en una línea inventada como esta: si no estás seguro de un dato, dilo y déjalo en blanco; prefiero un hueco a un dato inventado. La tienda de café de esta guía lo resolvió con [FALTA], y la panadería, pidiendo que la IA pregunte.
Pide la cita textual
Con documentos largos, Anthropic sugiere pedir primero las frases exactas del documento y trabajar después con ellas. También propone que cada afirmación lleve su respaldo: «Make Claude’s response auditable by having it cite quotes and sources for each of its claims». Traducción nuestra: haz que la respuesta de Claude se pueda auditar, pidiéndole que cite frases y fuentes para cada una de sus afirmaciones.
Y que se quede en el material que le diste, que es el límite que ya viste en las cinco piezas.
La ventaja es práctica. Una cita textual se comprueba en segundos con el buscador del documento. Si la frase no aparece en el original, la explicación que viene después tampoco vale.
Pregunta dos veces
Anthropic propone otra técnica. Su página la describe así: «Run Claude through the same prompt multiple times and compare the outputs». Traducción nuestra: ejecuta el mismo prompt varias veces con Claude y compara los resultados.
Encaja con lo que dice Microsoft sobre la misma instrucción y sus respuestas distintas. Lectura nuestra: si dos respuestas a la misma pregunta dan dos cifras distintas, ninguna es confiable todavía. Verifícala en su fuente.
Lo que una buena instrucción no arregla
Aquí entra el experimento del principio. Lo publicaron Fabrizio Dell’Acqua y sus coautores en la revista Organization Science, en línea desde el 11 de marzo de 2026. Participaron 758 consultores de Boston Consulting Group, cerca del 7 % de sus consultores de nivel individual. Fueron dos experimentos, «with no overlap between the groups». Traducción nuestra: sin que los grupos se repitieran. En las tareas dentro de la frontera trabajaron 385 personas, y en la de fuera, 373.
En cada experimento, un grupo trabajó sin IA, otro con GPT-4 y un tercero con GPT-4 más una capacitación. Así la describe el artículo: «These overview materials included instructional videos and documents that outlined and illustrated effective usage strategies». Traducción nuestra: estos materiales de introducción incluían videos y documentos que explicaban e ilustraban estrategias de uso eficaces.
Los autores llaman frontera al límite de lo que la IA hacía bien. Dentro de ella, la calidad fue 33.9 % mayor con la capacitación y 29.9 % mayor con la herramienta sola, frente al grupo sin IA. Fuera de la frontera pasó otra cosa. El artículo lo cuenta así: «Subjects in the control group were correct about this exercise about 84.5% of the time». Traducción nuestra: los participantes del grupo de control acertaron en este ejercicio cerca del 84.5 % de las veces.
Los grupos con IA acertaron menos. El artículo sigue: «but the AI conditions scored at 60% and 70.6%». Traducción nuestra: pero las condiciones con IA obtuvieron 60 % y 70.6 %. En la tabla del artículo, el 60 % es del grupo capacitado, y el 70.6 %, del que solo tuvo la herramienta. Juntos, los autores lo resumen como «an average decrease of 19 percentage points». Traducción nuestra: una caída promedio de 19 puntos porcentuales.
Cada columna de esta tabla viene de un experimento distinto, con personas distintas.
| Grupo | Calidad dentro de la frontera, frente al grupo sin IA | Aciertos fuera de la frontera |
|---|---|---|
| Sin IA | Base | 84.5 % |
| Con GPT-4 | +29.9 % | 70.6 % |
| Con GPT-4 y capacitación | +33.9 % | 60 % |
Lectura nuestra: la capacitación ayudó donde la IA ya era buena, y no evitó los errores donde no lo era. En lo que leí, el artículo no atribuye la caída del grupo capacitado a una sola causa, y el estudio se hizo con GPT-4, un modelo de 2023.
Anthropic lo dice desde el otro lado. Sus técnicas reducen las alucinaciones sin eliminarlas, y la página agrega: «Always validate critical information, especially for high-stakes decisions». Traducción nuestra: valida siempre la información crítica, sobre todo en decisiones de alto riesgo. Qué tareas se pueden dejar a la IA y cuáles no está en automatizaciones con IA que sí funcionan.
Mi criterio, y va como criterio: cualquier número, nombre, fecha o artículo de ley que salga de la IA y vaya a publicarse o a decidir algo, lo abriría en su fuente antes de usarlo. Si no tiene fuente, lo trataría como una pregunta, no como un dato.
La primera respuesta es un borrador
Las guías de OpenAI, Google y Microsoft cuentan con que haya correcciones. OpenAI lo dice en su ayuda para ChatGPT: «Prompt engineering often requires an iterative approach». Traducción nuestra: la ingeniería de prompts a menudo requiere un enfoque iterativo. Y Microsoft avisa en la suya: «Expect some back-and-forth conversation». Traducción nuestra: cuenta con algo de ida y vuelta en la conversación.
Corrige con datos, no con adjetivos
La corrección tiene el mismo problema que la instrucción vaga. Hazlo más profesional deja a la IA adivinando qué es profesional para ti.
Un ejemplo inventado con el aviso de la panadería. En lugar de hazlo más cálido, una corrección con datos: quita la segunda oración, cambia «les informamos» por «les cuento» y termina con la pregunta de cuántas piezas quieren apartar. La primera pide un adjetivo. La segunda dice qué cambiar.
La corrección cuesta tiempo, y el tiempo cuesta dinero. En cuánto cuesta usar IA en un negocio pequeño hicimos la cuenta en «Una consulta cuesta menos que un minuto»: un minuto de revisión puede costar más que la consulta. Lectura nuestra: una instrucción completa desde el principio puede ahorrarte rondas de corrección.
Cuándo empezar de nuevo
En una conversación larga, las correcciones se acumulan. Lo que pediste en el tercer mensaje puede chocar con lo que pides en el décimo. Y la guía de GPT-5 ya avisó que las instrucciones contradictorias pueden hacerle más daño a ese modelo que a otros.
En «Corrige en el mismo hilo», de «Las mejores herramientas de IA para emprendedores», recomendamos no empezar de cero cuando algo no sirve. Lectura nuestra: sigue valiendo para un ajuste o dos. Cuando las correcciones ya se contradicen, conviene juntarlas.
Mi criterio, y va como criterio: si después de tres correcciones la respuesta no mejora, abriría una conversación nueva con la instrucción ya corregida, completa, en un solo mensaje. Las correcciones que funcionaron pasan a la instrucción; las que no, se quedan atrás.
Pídele que mejore tu instrucción
La guía de GPT-5 cuenta que quienes lo probaron primero lo usaron para mejorar sus propias instrucciones: «early testers have found great success using GPT-5 as a meta-prompter for itself». Traducción nuestra: los primeros probadores tuvieron mucho éxito usando a GPT-5 como redactor de prompts para sí mismo.
La ayuda de los Gems de Google sugiere algo parecido: escribir una o dos oraciones y pedirle a Gemini que las reescriba antes de revisarlas tú.
Dos instrucciones inventadas para hacerlo. Antes de la tarea: antes de responder, dime qué datos te faltan para hacer bien esto. Después de una mala respuesta: reescribe mi instrucción para que la próxima vez salga como la quiero, y dime qué le agregaste.
La instrucción mejorada se revisa como cualquier otra respuesta. Puede agregar supuestos que no son tuyos.
Guarda las que funcionan
Una instrucción que funcionó te ahorra el tiempo que tardaste en afinarla. Guárdala en un documento, con la fecha, el asistente en que la usaste y un ejemplo del resultado. La próxima vez cambias los datos y la reusas.
Con el tiempo, las que repites cada semana son candidatas a un proyecto o a un Gem, como en «Deja fijo lo que repites». La instrucción fija de ChatGPT queda para lo que vale en cualquier conversación. Y si quieres que corran solas, sin que intervengas, eso ya es una automatización: el paso siguiente está en cómo automatizar tareas repetitivas.
Una advertencia, por lo que dice Microsoft sobre las respuestas distintas: una instrucción guardada no da siempre el mismo resultado. Revisa cada uno como si fuera el primero.
¿En español o en inglés?
Hay quien escribe sus instrucciones en inglés porque cree que así la IA responde mejor. Anthropic publica un dato que se acerca a la pregunta, y la diferencia que muestra es pequeña.
Lo que miden los datos de Anthropic
Anthropic publica una tabla con el desempeño de sus modelos por idioma, con el inglés como 100 %. La prueba es MMLU, un examen de conocimientos de muchas materias, traducido a 14 idiomas por traductores profesionales, y los modelos respondieron con pensamiento extendido.
En español, Claude Sonnet 4.5 obtuvo 98.2 % de lo que obtuvo en inglés, y Claude Haiku 4.5, 96.4 %. Son 1.8 y 3.6 puntos de distancia.
Dos salvedades. La tabla solo trae esos dos modelos, y el primero ya está retirado. Y no revisé si OpenAI, Google o Microsoft publican una tabla parecida.
Lectura nuestra: con Claude, para las tareas de un negocio que vende en México, escribir en español cuesta poco en desempeño. Y si escribes en inglés para que te responda en español, agregas una traducción que puede meter errores de tono o de términos.
Di qué español quieres
Anthropic recomienda decir el idioma aunque el modelo pueda detectarlo: «Although Claude can detect the target language automatically, explicitly stating the desired input and output languages improves reliability». Traducción nuestra: aunque Claude puede detectar el idioma de destino por sí solo, decir de forma explícita el idioma de entrada y el de salida que quieres mejora la confiabilidad.
El español tiene variantes. Y la tuya importa en un texto para clientes. El trato de tú o de usted, la moneda, la forma de escribir fechas y las palabras de cada país cambian de una a otra.
Mi criterio, y va como criterio: en la instrucción fija pondría una línea con cinco datos. Español de México, de tú o de usted, pesos mexicanos, fechas con día, mes y año, y el sistema métrico. Si el material viene en inglés, como un contrato de un proveedor extranjero, diría también en qué idioma quiero la respuesta.
Lo que no conviene pegar
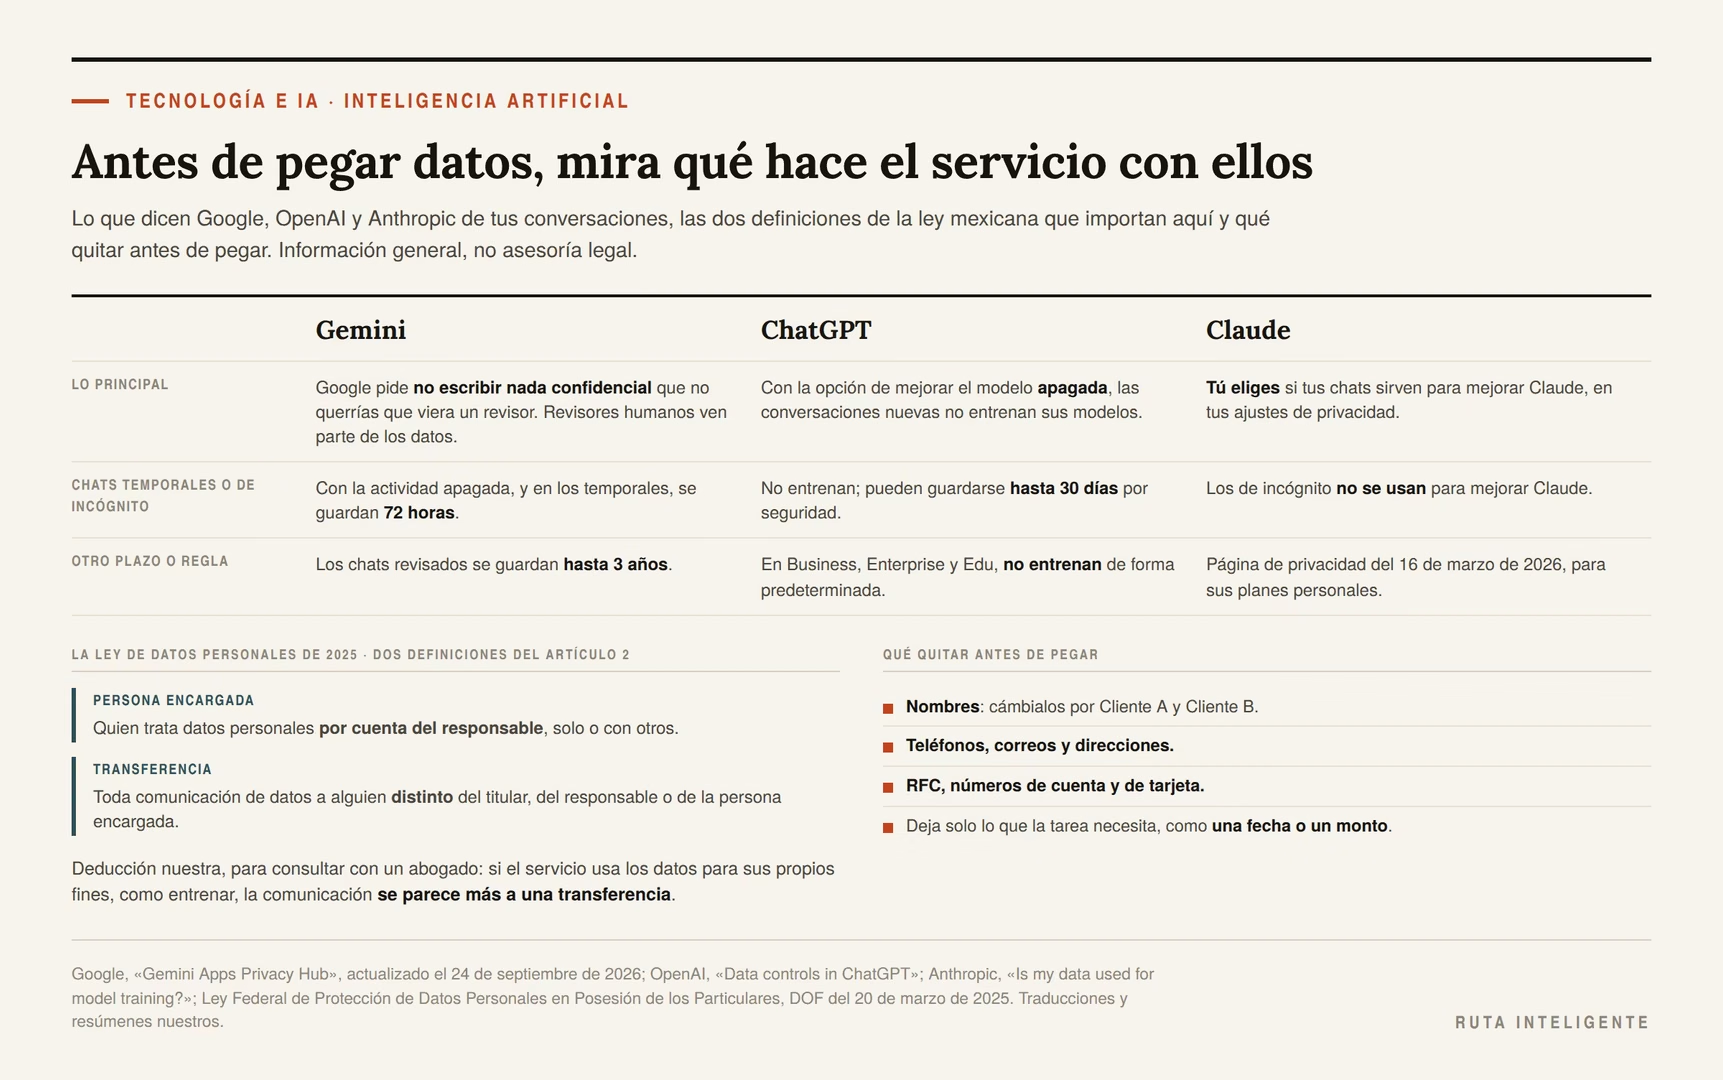
Una instrucción completa pide contexto, y el contexto de un negocio incluye datos de personas. Antes de pegar, conviene saber qué hace cada servicio con lo que escribes. Esta sección es información general, no asesoría legal.
Lo que dicen los propios servicios
Los tres lo explican en sus páginas. Google lo pide de forma directa en su centro de privacidad de Gemini, actualizado el 24 de septiembre de 2026: «Please don’t enter confidential information that you wouldn’t want a reviewer to see». Traducción nuestra: por favor, no escribas información confidencial que no querrías que viera un revisor.
La razón está en la misma página. Lo dice así: «Human reviewers (including trained reviewers from our service providers) review some of the data we collect». Traducción nuestra: revisores humanos, incluidos revisores capacitados de nuestros proveedores, revisan parte de los datos que recopilamos.
Y dos plazos de esa misma página. Con la actividad apagada, y en los chats temporales, las conversaciones se guardan 72 horas: «Temporary chats and chats you have when Keep Activity is off are retained with your account for 72 hours». Traducción nuestra: los chats temporales y los que tienes con la actividad apagada se conservan con tu cuenta durante 72 horas. Y los que pasan por revisión: «Reviewed chats are retained for up to three years». Traducción nuestra: los chats revisados se conservan hasta tres años.
OpenAI permite apagar el entrenamiento. Lo explica así: «When Improve the model for everyone is off, your new conversations won’t be used to train OpenAI models». Traducción nuestra: cuando la opción de mejorar el modelo para todos está apagada, tus conversaciones nuevas no se usan para entrenar los modelos de OpenAI.
Sus chats temporales «are not used to improve OpenAI models», aunque «may be retained for up to 30 days for safety purposes». Traducción nuestra: no se usan para mejorar los modelos de OpenAI, aunque pueden conservarse hasta 30 días por motivos de seguridad. Y en sus planes de empresa la regla es otra: «By default, OpenAI does not use content from ChatGPT Business, Enterprise, Edu, or ChatGPT for Healthcare workspaces to train its models». Traducción nuestra: de forma predeterminada, OpenAI no usa el contenido de los espacios de trabajo de ChatGPT Business, Enterprise, Edu ni ChatGPT for Healthcare para entrenar sus modelos.
Anthropic deja la decisión en tus manos. En sus planes para personas, dice: «You choose to allow us to use your chats and coding sessions to improve Claude». Traducción nuestra: tú eliges si nos permites usar tus chats y sesiones de programación para mejorar Claude. Y sus chats de incógnito quedan fuera: «Your Incognito chats are not used to improve Claude, even if you have enabled Model Improvement». Traducción nuestra: tus chats de incógnito no se usan para mejorar Claude, aunque hayas activado la mejora del modelo.
| Servicio | Qué pasa con tus conversaciones | Chats temporales o de incógnito |
|---|---|---|
| Gemini | Revisores humanos ven parte de los datos; los revisados se guardan hasta tres años | Con la actividad apagada, 72 horas |
| ChatGPT | Con la opción apagada, las nuevas no entrenan; en Business, Enterprise y Edu, no entrenan de forma predeterminada | No entrenan; hasta 30 días por seguridad |
| Claude | Tú eliges en tus ajustes de privacidad | Los de incógnito no se usan para mejorar Claude |
Los datos de tus clientes
La Ley Federal de Protección de Datos Personales en Posesión de los Particulares, de 2025, tiene dos definiciones que importan aquí. Una es la de «Persona encargada: Persona física o jurídica que sola o conjuntamente con otras trate datos personales por cuenta del responsable».
La otra es la de transferencia: «Toda comunicación de datos personales dentro o fuera del territorio mexicano, realizada a persona distinta de la titular, del responsable o de la persona encargada del tratamiento».
Deducción nuestra, que conviene consultar con un abogado: si un servicio de IA trata los datos de tus clientes solo por tu cuenta, su papel se parece al de una persona encargada. Si los usa para sus propios fines, como entrenar sus modelos, la comunicación se parece más a una transferencia. Por eso el ajuste de entrenamiento de la sección anterior no es un detalle técnico.
En «Pegar tu lista de clientes es una transferencia de datos», de «Las mejores herramientas de IA para emprendedores», la serie lo planteó de forma más tajante. Esta lectura lo matiza: depende de qué haga el servicio con los datos.
Quita los nombres antes de pegar
En las cinco tareas de este artículo, la IA no necesita saber quién es tu cliente. Necesita saber qué pasó.
Antes de pegar, cambia los nombres por Cliente A y Cliente B. Quita teléfonos, correos, direcciones, RFC, números de cuenta y de tarjeta. Si un dato hace falta para la tarea, como una fecha o un monto, déjalo; si no, quítalo. El contrato y los gastos de los ejemplos van así.
Mi criterio, y va como criterio: lo que no le mandaría por correo a un proveedor con el que no tengo contrato, no lo pegaría en un asistente de IA. Y si el trabajo lo exige, usaría un plan de empresa que no entrene de forma predeterminada y revisaría sus condiciones.
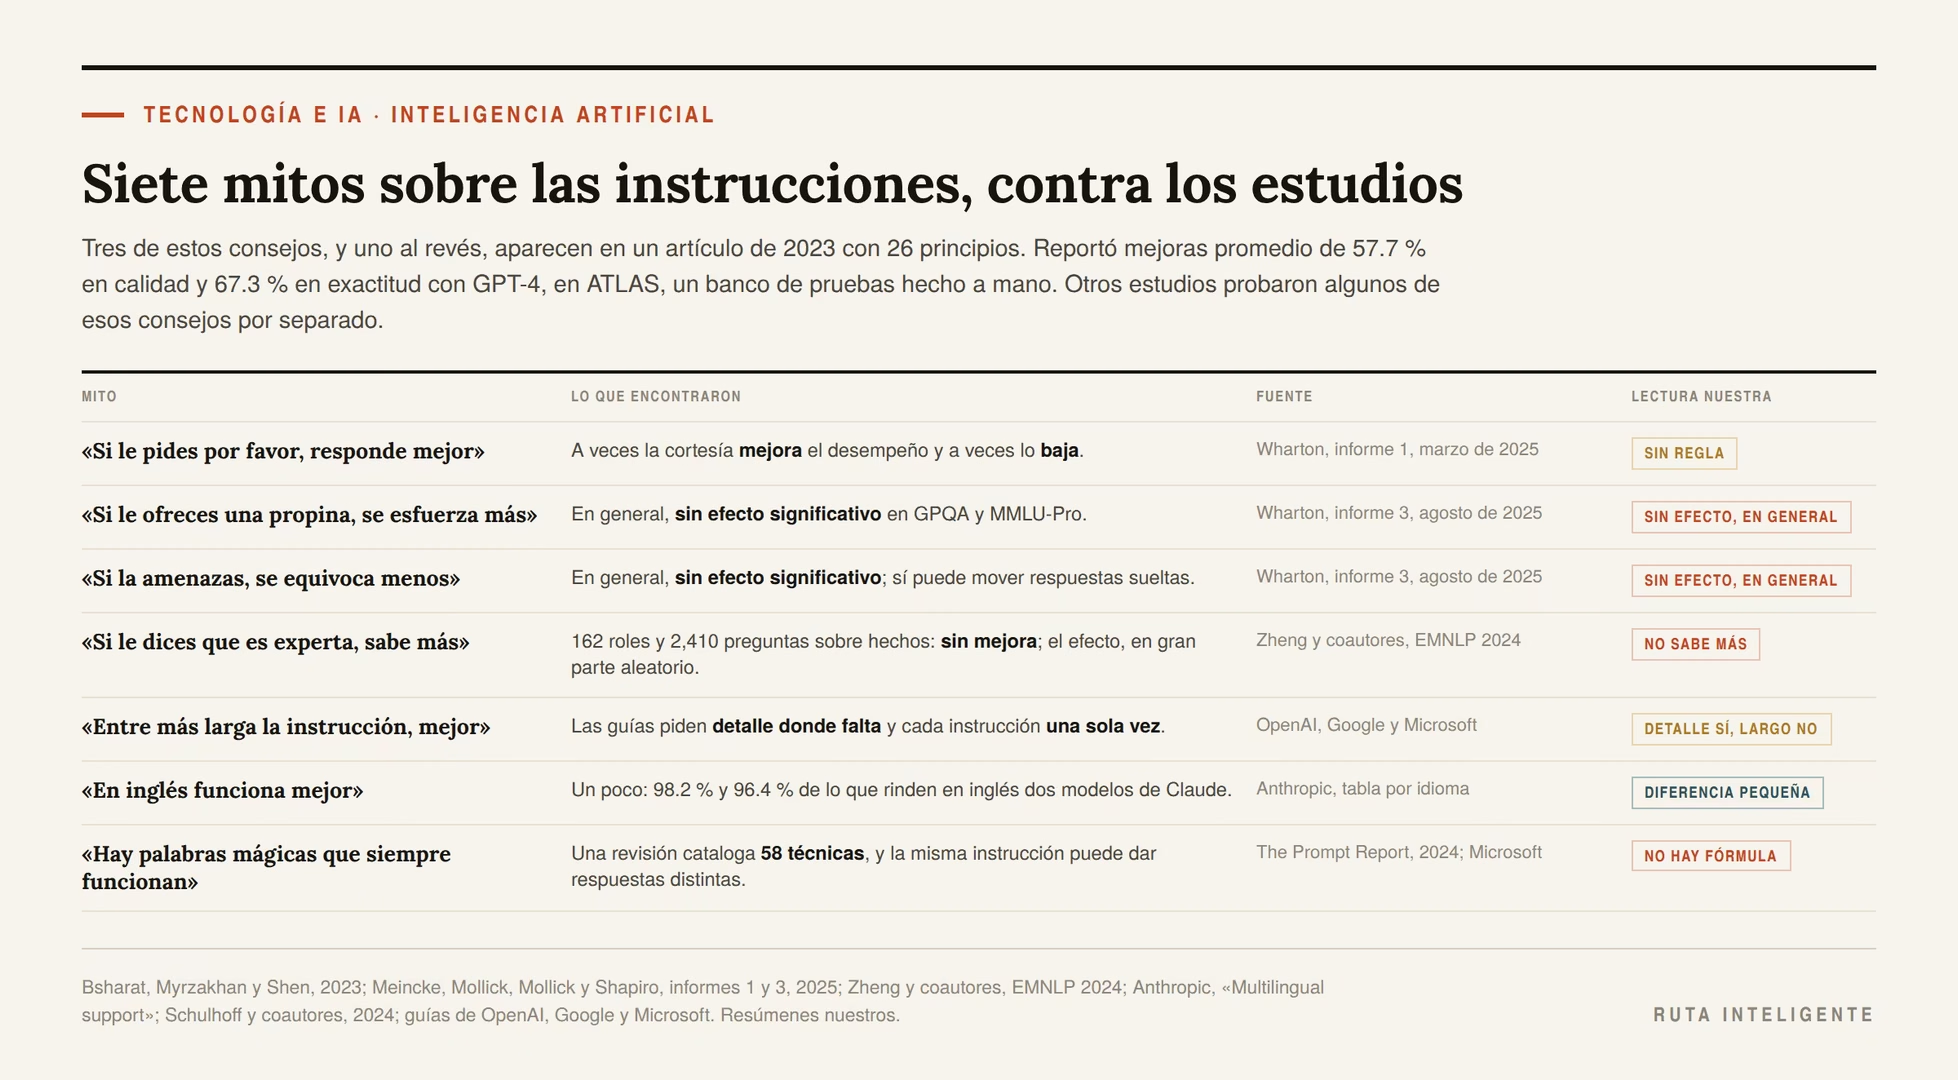
Siete mitos sobre las instrucciones
Siete ideas que circulan sobre cómo pedirle las cosas a una IA, y lo que dicen los estudios y las guías. Tres aparecen como consejos, y uno como su contrario, en un artículo de diciembre de 2023 con 26 principios para escribir instrucciones. Sus autores, Sondos Mahmoud Bsharat, Aidar Myrzakhan y Zhiqiang Shen, reportaron que sus principios «enhanced both the quality and accuracy of the LLM responses by an average of 57.7% and 67.3%». Traducción nuestra: mejoraron la calidad y la exactitud de las respuestas en un promedio de 57.7 % y 67.3 %.
Esas cifras son promedios sobre los principios, con GPT-4, no el resultado de uno en particular. Se midieron en ATLAS, que el artículo describe como «a manually crafted benchmark for principled prompt evaluation». Traducción nuestra: un banco de pruebas hecho a mano para evaluar instrucciones con principios. La calidad la juzgaron personas. Otros estudios probaron algunos de esos consejos por separado.
«Si le pides por favor, responde mejor»
El artículo de los 26 principios proponía prescindir de la cortesía. Su primer principio dice «No need to be polite with LLM». Traducción nuestra: no hace falta ser cortés con un modelo de lenguaje.
El laboratorio de IA generativa de la Wharton School lo probó en marzo de 2025. No encontró una regla en ningún sentido: «sometimes being polite to the LLM helps performance, and sometimes it lowers performance». Traducción nuestra: a veces ser cortés con el modelo mejora el desempeño, y a veces lo baja.
Lectura nuestra: escribe con la cortesía que te salga natural. No es una palanca confiable: a veces sube el desempeño y a veces lo baja.
«Si le ofreces una propina, se esfuerza más»
El sexto principio de 2023 proponía agregar «I’m going to tip $xxx for a better solution!». Traducción nuestra: te voy a dar una propina de tantos dólares por una mejor solución.
En agosto de 2025, 584 días después, el mismo laboratorio de Wharton publicó un informe dedicado a las propinas y las amenazas. Lo probó en dos bancos de pruebas, GPQA y MMLU-Pro. Su conclusión: «Threatening or tipping a model generally has no significant effect on benchmark performance». Traducción nuestra: amenazar o dar propina a un modelo en general no tiene un efecto significativo en su desempeño en los bancos de pruebas.
«Si la amenazas, se equivoca menos»
El décimo principio de 2023 sugería frases como «You will be penalized». Traducción nuestra: serás penalizado. El informe de Wharton de 2025 lo probó junto con las propinas. El resultado fue el mismo. Sin efecto significativo, en general.
El mismo informe agrega un matiz: «Prompt variations can significantly affect performance on a per-question level». Traducción nuestra: las variaciones del prompt pueden afectar de forma significativa el desempeño pregunta por pregunta. Lectura nuestra: un cambio de redacción puede mover una respuesta concreta para bien o para mal, sin que eso se vuelva una regla.
«Si le dices que es experta, sabe más»
El principio 16 de 2023 decía «Assign a role to the large language models». Traducción nuestra: asígnales un rol a los modelos de lenguaje grandes.
Un estudio publicado en 2024 en la serie Findings de la conferencia EMNLP midió el efecto de los roles. Sus autores, encabezados por Mingqian Zheng, lo describen así: «We curate a list of 162 roles covering 6 types of interpersonal relationships and 8 domains of expertise». Traducción nuestra: reunimos una lista de 162 roles que cubren 6 tipos de relaciones interpersonales y 8 campos de especialidad.
Los probaron con cuatro familias de modelos y 2,410 preguntas sobre hechos. El resultado: «adding personas in system prompts does not improve model performance across a range of questions». Traducción nuestra: agregar roles en las instrucciones del sistema no mejora el desempeño del modelo en una variedad de preguntas. Y además, «the effect of each persona can be largely random». Traducción nuestra: el efecto de cada rol puede ser en gran parte aleatorio.
Lectura nuestra, junto con lo que dice Anthropic: el rol puede servir para el tono y el enfoque. No convierte a la IA en experta en lo que no sabe.
«Entre más larga la instrucción, mejor»
Las guías piden detalle donde falta, no largo por sí mismo. OpenAI pide ser lo más detallado posible sobre lo que buscas, y la ayuda de los Gems, todos los antecedentes que puedas. Pero Microsoft pone el mínimo en un objetivo claro, y la guía de GPT-6 pide decir cada instrucción una sola vez. La de OpenAI para modelos de razonamiento pide instrucciones simples y directas.
Deducción nuestra: lo largo trae otro riesgo, porque con más reglas hay más posibilidades de que dos choquen. Las cinco instrucciones completas de esta guía tienen entre 89 y 106 palabras.
«En inglés funciona mejor»
En la tabla de Anthropic, un poco. En una prueba de conocimientos traducida por profesionales, Claude Sonnet 4.5 rindió en español 98.2 % de lo que rindió en inglés, y Claude Haiku 4.5, 96.4 %.
Son 1.8 y 3.6 puntos. Lectura nuestra: para un texto que va a leer un cliente en México, esa diferencia pesa menos que el riesgo de traducir de ida y de vuelta.
«Hay palabras mágicas que siempre funcionan»
En 2024, un grupo de 31 autores revisó la literatura y armó «a taxonomy of 58 LLM prompting techniques». Traducción nuestra: una clasificación de 58 técnicas de prompting para modelos de lenguaje. Lectura nuestra: si hubiera una fórmula, no harían falta 58.
El primer informe de Wharton, de marzo de 2025, se tituló «Prompting Science Report 1: Prompt Engineering is Complicated and Contingent». Traducción nuestra: Informe 1 sobre la ciencia de los prompts: la ingeniería de prompts es complicada y depende de las circunstancias. Y el tercero encontró que un cambio de redacción puede mover respuestas concretas sin que eso se vuelva una regla.
Microsoft lo recuerda en su ayuda: la misma instrucción puede dar respuestas distintas. Lo que se repite en las guías de las cuatro empresas no es una palabra: es decir qué quieres, con qué contexto y en qué formato.
Una plantilla para copiar
Dos versiones para copiar y llenar. La corta trae las cinco piezas; la larga deja fuera los ejemplos y agrega la cita textual. Los corchetes son los espacios que llenas tú. Son una síntesis nuestra de las seis guías, no la plantilla oficial de ninguna empresa.
La versión corta
Para un texto, una respuesta o una lista, cuando no hay un documento largo de por medio. Tiene 55 palabras.
Contexto: [quién eres, qué vendes y para quién es esto].
Tarea: [un verbo y un entregable], para [lo que quieres lograr].
Formato: [largo], [párrafo, lista o tabla], [tono], [tú o usted].
Ejemplo: [un texto tuyo que ya funcionó].
Límites: usa solo [el material que te doy]. Si te falta un dato, pregúntame o escribe [FALTA].
No todas las líneas hacen falta siempre. Si tienes varios ejemplos, pega de 3 a 5, cada uno con su etiqueta; si no tienes ninguno, quita esa línea. Si la tarea no tiene material, la línea de límites puede quedarse solo con lo que hay que hacer si falta un dato.
La versión con un documento largo
Para un contrato, un reporte, una conversación o un archivo de datos. El documento va arriba y la tarea abajo, como piden Anthropic y Google. Tiene 65 palabras, contando el marcador del documento.
Abajo, entre comillas triples, va [qué documento es y de dónde salió].
"""
[el documento]
«»» Contexto: [quién eres y para qué necesitas esto]. Tarea: [un verbo y un entregable], solo con lo que dice el documento. Para cada punto, copia primero la frase exacta del documento y luego explícala. Si el documento no trata algo, dilo en lugar de completarlo. Formato: [largo], [lista o tabla], [tono].
La línea de la frase exacta es la que te permite revisar la respuesta contra el original. Y la línea de lo que no trata el documento le da a la IA una salida distinta de inventar.
Ocho preguntas antes de enviar
Repásalas antes de mandar una instrucción para algo que importa.
- ¿Alguien nuevo en mi negocio entendería qué quiero sin preguntarme?
- ¿Dije para quién es el resultado y para qué lo quiero?
- ¿Dije el largo en palabras, oraciones o renglones?
- ¿Dije la forma: párrafo, lista o tabla, y con qué columnas?
- ¿Pegué un ejemplo, si lo tengo, marcado como ejemplo?
- ¿Dije con qué material trabajar y qué hacer si falta un dato?
- Si hay un documento largo, ¿está arriba, y la tarea abajo?
- ¿Quité nombres, cuentas y cualquier dato que no le daría a un desconocido?
Si una respuesta es no, ahí está lo que falta. Y si la tarea se repite cada semana, guarda la instrucción terminada, como en «Guarda las que funcionan».
Preguntas frecuentes
¿Qué es un prompt?
Es la instrucción o la pregunta que le escribes a un asistente de IA. La ayuda de OpenAI lo define así: «A prompt for a Large Language Model (LLM) is a text input that initiates a conversation or triggers a response from the model». Traducción nuestra: un prompt para un modelo de lenguaje grande es un texto que inicia una conversación o provoca una respuesta del modelo. En esta guía lo llamamos instrucción.
¿Hay que aprender ingeniería de prompts?
Lectura nuestra: no como disciplina. Una revisión de 2024 catalogó 58 técnicas, pero las guías de las cuatro empresas coinciden en algo mucho más corto: decir qué quieres, dar el contexto y pedir un formato. Con eso, los ejemplos y los límites cubres las tareas de este artículo.
¿Se escribe igual para ChatGPT, Gemini, Claude y Copilot?
En lo básico, sí: las guías de las cuatro empresas piden lo mismo en tres puntos. En los detalles, no. Difieren en cuántos ejemplos dar, dónde poner la pregunta y si conviene darle un rol. No comparé cómo responde cada uno. Como criterio propio, si una regla de esta guía choca con la de tu asistente, seguiría la de su fabricante.
¿Cuántos ejemplos le doy?
Anthropic recomienda de 3 a 5. Google, en la guía de su API, recomienda incluirlos siempre y avisa que, con demasiados, el modelo puede empezar a ajustarse de más a ellos. OpenAI pide probar primero sin ejemplos con sus modelos de razonamiento. Para un texto con tu voz, como un mensaje a clientes, empezaría con tres tuyos, distintos entre sí.
¿Sirve decirle que actúe como experta?
Para el tono y el enfoque, puede servir: Anthropic lo recomienda para eso. Para saber más, en el estudio que encontré no ayudó. Ese estudio, de 2024, probó 162 roles con 2,410 preguntas sobre hechos, y agregar un rol no mejoró el desempeño.
¿Le escribo en inglés para que responda mejor?
Con Claude, no hace falta. En la tabla de Anthropic, Claude rindió en español entre 96.4 % y 98.2 % de lo que rindió en inglés, según el modelo. De los otros asistentes no revisé datos parecidos. Lo que sí conviene es decir en qué español quieres la respuesta: de México, de tú o de usted, en pesos.
¿Es normal que me dé respuestas distintas a la misma pregunta?
Sí. Microsoft lo avisa en su ayuda: la misma instrucción, usada varias veces, puede dar respuestas distintas. Anthropic propone usarlo a tu favor: pedir lo mismo varias veces y comparar. Si dos respuestas dan dos cifras distintas, verifica en la fuente antes de usar cualquiera.
¿Cómo evito que invente datos?
No hay forma de evitarlo del todo: Anthropic dice que sus técnicas reducen las alucinaciones sin eliminarlas. Lo que ayuda es pedirle que use solo el material que le das, darle permiso de decir que no sabe y pedirle la frase exacta del documento antes de su explicación. Y revisar en su fuente todo dato que vayas a publicar.
¿Puedo pegar datos de mis clientes?
Revisa antes qué hace el servicio con tus conversaciones. Google pide no escribir en Gemini nada confidencial que no quieras que vea un revisor. OpenAI y Anthropic te dejan apagar el uso de tus chats para entrenar. Y la ley mexicana de datos personales distingue entre tratar datos por cuenta de alguien y comunicarlos a otro. Una salida simple es quitar nombres y datos de contacto antes de pegar. Información general, no asesoría legal.
¿Dónde guardo las instrucciones que uso siempre?
Hay tres niveles. Lo que vale para todas tus conversaciones va en las instrucciones personalizadas de ChatGPT. Lo que vale para un tipo de trabajo, en un proyecto de Claude o en un Gem de Gemini. Y lo de cada tarea, en un documento aparte con la fecha y un ejemplo del resultado, para copiarlo y cambiar los datos.
Lo que este artículo no pudo verificar
Esto quedó fuera o a medias. Conviene saberlo antes de usar cualquier dato de arriba.
- La cifra de las 21 palabras. Circula que los prompts más útiles rondan las 21 palabras y que los usuarios escriben menos de nueve, atribuida a una guía de Google de 2024. Solo la encontré en notas de prensa y en sitios que la citan, no en una página de Google, y por eso no se usa en el resto del artículo.
- Cómo midió Anthropic la mejora de hasta 30 % al poner la pregunta al final. En lo que leí, su página no describe las pruebas.
- Si OpenAI, Google o Microsoft publican una tabla de desempeño por idioma como la de Anthropic. No la busqué.
- Por qué al grupo capacitado le fue peor fuera de la frontera en el experimento de Boston Consulting Group. En lo que leí, el artículo no lo atribuye a una sola causa.
- Qué modelos probaron los informes de Wharton. Los resúmenes que leí no los nombran.
- Cómo explica Microsoft cada una de sus cuatro partes. Lo hace en una imagen, que no se pudo leer como texto.
- Qué hace la función Generate Anything que recomienda la guía de OpenAI para su API. No la revisé.
- Las fechas de actualización de las ayudas de OpenAI. Muestran que se actualizaron hace dos meses, sin un día exacto. La guía de Google para Workspace no muestra fecha.
- Si los modos de razonamiento de las aplicaciones de cada empresa son lo mismo que OpenAI llama modelos de razonamiento en su guía para la API. Los nombres varían de una empresa a otra, y no los comparé.
- Las instrucciones de ejemplo. No las probé en ningún asistente. Son ilustraciones de las reglas.
Fuentes y metodología
Las traducciones del inglés de este artículo son nuestras, y cada cita está enlazada a su original en esta sección. Las citas de Anthropic en español son de su documentación en español. Las fuentes se consultaron el 8 de octubre de 2026, salvo donde se indica otra fecha.
Fuentes primarias
Guías de las empresas
- Anthropic, buenas prácticas de prompting, versión en español, cotejada con la versión en inglés. De ahí salen la prueba del colega, el empleado nuevo, la claridad, el contexto y el motivo. También los 3 a 5 ejemplos, las etiquetas XML, el rol, los documentos largos, encadenar prompts y el ejemplo de los puntos suspensivos.
- Anthropic, «Reduce hallucinations»: permiso para admitir incertidumbre, citas, solo el material dado, varias corridas y validar lo crítico.
- Anthropic, «Multilingual support»: la tabla por idioma y la recomendación de decir el idioma.
- OpenAI, «Best practices for prompt engineering with the OpenAI API», con sus nueve reglas, y «Prompt engineering best practices for ChatGPT», con la claridad, el contexto y las correcciones. Las dos dicen que se actualizaron hace dos meses.
- OpenAI, «Reasoning best practices».
- OpenAI, «GPT-4.1 Prompting Guide», del 14 de abril de 2025, y «GPT-5 prompting guide», del 7 de agosto de 2025, las dos marcadas como archivadas. La familia posterior está en «Using GPT-6», de donde salen las instrucciones largas de GPT-6 Astra y la regla de decir cada instrucción una sola vez.
- Google, «Prompt design strategies», para la API de Gemini, con su sección de Gemini 3.
- Google Workspace, guía para escribir prompts eficaces, en su edición en inglés para Sudáfrica, la que se pudo consultar, sin fecha visible: las cuatro áreas y los consejos para iterar.
- Microsoft, ayuda para escribir prompts en Copilot: las cuatro partes, el objetivo claro, las respuestas distintas y la revisión.
Instrucciones fijas y privacidad
- OpenAI, «ChatGPT Custom Instructions» y «Data controls in ChatGPT».
- Anthropic, «What are projects?» e «Is my data used for model training?», del 16 de marzo de 2026.
- Google, «Tips for creating custom Gems» y «Gemini Apps Privacy Hub», actualizado el 24 de septiembre de 2026.
- Ley Federal de Protección de Datos Personales en Posesión de los Particulares, publicada en el Diario Oficial de la Federación el 20 de marzo de 2025. Del artículo 2 salen las definiciones de persona encargada y de transferencia. Verificada el 8 de octubre de 2026 para «Cómo migrar de otra plataforma a WooCommerce sin perder ventas».
Estudios
- Banco de México, recuadro «Opinión empresarial sobre la adopción de inteligencia artificial en México y su impacto en el empleo y la productividad», Reporte sobre las Economías Regionales de abril a junio de 2026. De ahí sale la encuesta de junio de 2026 a empresas de más de 100 trabajadores. Verificado el 7 de octubre de 2026 para «Cuánto cuesta usar IA en un negocio pequeño».
- Dell’Acqua y coautores, «Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality». Organization Science, en línea desde el 11 de marzo de 2026, DOI 10.1287/orsc.2025.21838. Son dos experimentos, de 385 y 373 personas. La página de la revista no permite la lectura automática; se leyó la copia de Harvard Business School.
- Chatterji y coautores, «How People Use ChatGPT», NBER, documento de trabajo 34255, septiembre de 2025. También su versión en PDF en el sitio de OpenAI, con la muestra de mayo de 2024 a junio de 2025.
- OpenAI, «Why language models hallucinate», del 5 de septiembre de 2025.
- Meincke, Mollick, Mollick y Shapiro, del laboratorio de IA generativa de la Wharton School, firman los tres informes.
- «Prompting Science Report 1: Prompt Engineering is Complicated and Contingent», del 4 de marzo de 2025.
- «Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting», del 8 de junio de 2025.
- «Prompting Science Report 3: I’ll pay you or I’ll kill you — but will you care?», del 1 de agosto de 2025.
- Zheng, Pei, Logeswaran, Lee y Jurgens, «When “A Helpful Assistant” Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models». Findings of the Association for Computational Linguistics: EMNLP 2024, páginas 15126 a 15154.
- Liu y coautores, «Lost in the Middle: How Language Models Use Long Contexts», Transactions of the Association for Computational Linguistics, volumen 12, 2024, páginas 157 a 173.
- Schulhoff y coautores, «The Prompt Report: A Systematic Survey of Prompt Engineering Techniques», del 6 de junio de 2024.
- Bsharat, Myrzakhan y Shen, «Principled Instructions Are All You Need for Questioning LLaMA-1/2, GPT-3.5/4», del 26 de diciembre de 2023: los 26 principios, ATLAS y los promedios de 57.7 % y 67.3 %.
Cálculos y supuestos
Todas las cuentas son propias y están en un guion que las recalcula.
- Palabras de las instrucciones de ejemplo: cada palabra o cifra separada por espacios cuenta como una; los marcadores entre corchetes cuentan, y las tres comillas no. Antes: 14, 5, 4, 3 y 3, que suman 29, con promedio de 29 ÷ 5 = 5.8. Después: 100, 106, 89, 93 y 89, que suman 477, con promedio de 477 ÷ 5 = 95.4.
- Plantillas: la corta, 55 palabras; la larga, 65, contando el marcador del documento.
- Instrucción fija de ejemplo: 581 caracteres, contando espacios y saltos de línea, y 103 palabras. Frente al límite de 1,500 de Free y Go: 581 ÷ 1,500 = 38.7 %, y 1,500 − 581 = 919 caracteres libres.
- Experimento de Boston Consulting Group: 385 + 373 = 758 personas. Puntos porcentuales entre tasas de aciertos del mismo artículo. 84.5 − 70.6 = 13.9 y 84.5 − 60 = 24.5, las dos caídas que el artículo publica; 70.6 − 60 = 10.6 entre los dos grupos con IA. Dentro de la frontera, 33.9 − 29.9 = 4.0 puntos entre los dos grupos con IA.
- Idiomas: 100 − 98.2 = 1.8 y 100 − 96.4 = 3.6 puntos.
- Días: del 26 de diciembre de 2023, fecha del artículo de los 26 principios, al 1 de agosto de 2025, fecha del tercer informe de Wharton, van 584 días.
- Redondeo: hacia arriba desde el medio, a un decimal.
Comprobaciones cruzadas
- Cada cita se leyó dos veces, en fragmentos cortos. Cuando dos lecturas dieron dos redacciones, se citó solo lo que coincidió o se parafraseó. Pasó con tres frases: la de OpenAI sobre la cadena de pensamiento en los modelos de razonamiento y la de su guía de GPT-4.1 sobre la oración que basta. También con la de Microsoft sobre la conversación de ida y vuelta, que se citó solo en su primera parte.
- El 19 del experimento. El resumen del artículo dice que los participantes con IA fueron 19 % menos propensos a acertar, y el cuerpo, que la caída fue de 19 puntos porcentuales. Se usó la del cuerpo, que coincide con el promedio de las dos caídas: (13.9 + 24.5) ÷ 2 = 19.2.
- Qué grupo sacó 60 % y cuál 70.6 %. La frase del artículo no lo dice; su tabla 2, leída dos veces, da 0.60 al grupo capacitado y 0.71 al que solo tuvo la herramienta.
- Las mejoras de calidad. 1.48 ÷ 4.37 da 33.9 %, como publica el artículo. 1.31 ÷ 4.37 da 30.0 %, y el artículo publica 29.9 %; la diferencia sale de redondear los coeficientes, y se usó la cifra publicada.
- Las citas de Anthropic en español se cotejaron con la versión en inglés. Los ejemplos de instrucciones, como el de los puntos suspensivos, aparecen en inglés en las dos.
- Las fechas de los estudios. La primera versión del estudio de los roles es de noviembre de 2023, un mes antes del de los 26 principios, aunque se publicó en 2024. Por eso el artículo no lo presenta como una respuesta a los principios.
- Coherencia con la serie. Este artículo matiza tres apartados de «Las mejores herramientas de IA para emprendedores». «Dile qué no quieres», con la regla de decir qué hacer. «Corrige en el mismo hilo», con el límite de las correcciones que se contradicen. Y «Pegar tu lista de clientes es una transferencia de datos», con la definición de persona encargada.
Limitaciones
- No se probó ninguna instrucción para este artículo, y no se comparó el desempeño de los asistentes.
- Las guías de las empresas cambian sin aviso. Son las del 8 de octubre de 2026.
- Los estudios usaron modelos que ya tienen sucesores; los informes de Wharton no los nombran en sus resúmenes. Sus resultados describen esos modelos, no necesariamente los de hoy.
- La tabla de idiomas de Anthropic cubre dos de sus modelos, y uno ya está retirado.
- Los nombres de los menús en español pueden variar según la versión de cada aplicación. Las ayudas de OpenAI, Google y Microsoft se leyeron en inglés.
- La parte legal es una lectura de dos definiciones de la ley, no una opinión jurídica. Información general, no asesoría legal.
Declaración de intereses
Este artículo no contiene enlaces de afiliado, y no hay relación comercial con OpenAI, Anthropic, Google, Microsoft, Boston Consulting Group ni los autores de los estudios citados. Si en el futuro se agregan enlaces de afiliado, esta declaración se cambia el mismo día.